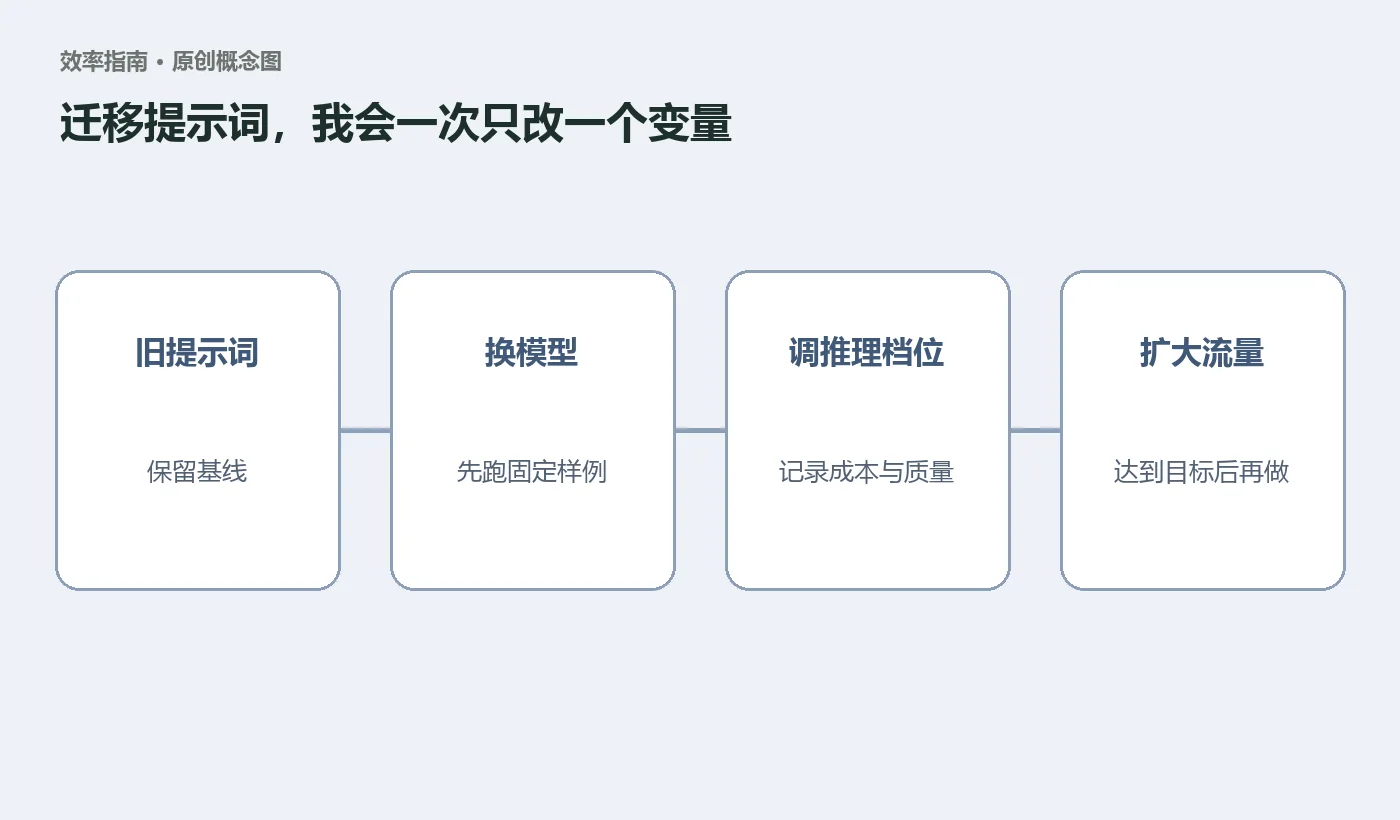
模型一升级,很多人的第一反应是把提示词从头重写。我通常不会这么做。旧提示词里已经验证过的业务规则、输出结构和边界都很值钱,直接推倒反而不知道是哪一处改动带来效果。换到GPT-6 Astra,我更愿意做一次小步迁移:先让旧任务跑起来,再针对新模型的行为逐项调。
这篇基于OpenAI当前的GPT-6 Astra模型指南整理,适合正在用API做内容、研究、代码或浏览器自动化的人。文中的配置示例需要结合自己的SDK版本和权限测试。
第一步:先改模型,再做一组固定样例
官方文档建议在Responses API请求里把model设为gpt-6-astra。Astra支持low、medium、high、xhigh和max推理档位,不支持none。如果旧配置用的是none或minimal,官方建议先从low开始比较;其他情况先保留原来的有效档位。
我会准备10到30个固定任务,至少包含:最常见任务、最难任务、容易答错的边界题、需要工具的流程和一条会中途改需求的任务。每次只改一个变量,记录成功率、总耗时、输出长度和返工次数。
| 任务类型 | 起始档位 | 我会看的指标 |
|---|---|---|
| 分类、改写、抽取 | low | 格式正确率、延迟 |
| 多步研究、复杂代码 | medium或high | 完成率、事实错误 |
| 高风险复杂决策 | xhigh或max | 人工复核结果、成本 |
第二步:把“做完”写清楚
OpenAI的模型指南提到,Astra更愿意在额外信息可能改变结果时提问。这对复杂协作很有帮助,但在无人值守任务里,也可能让流程停在一个其实可以合理假设的小问题上。
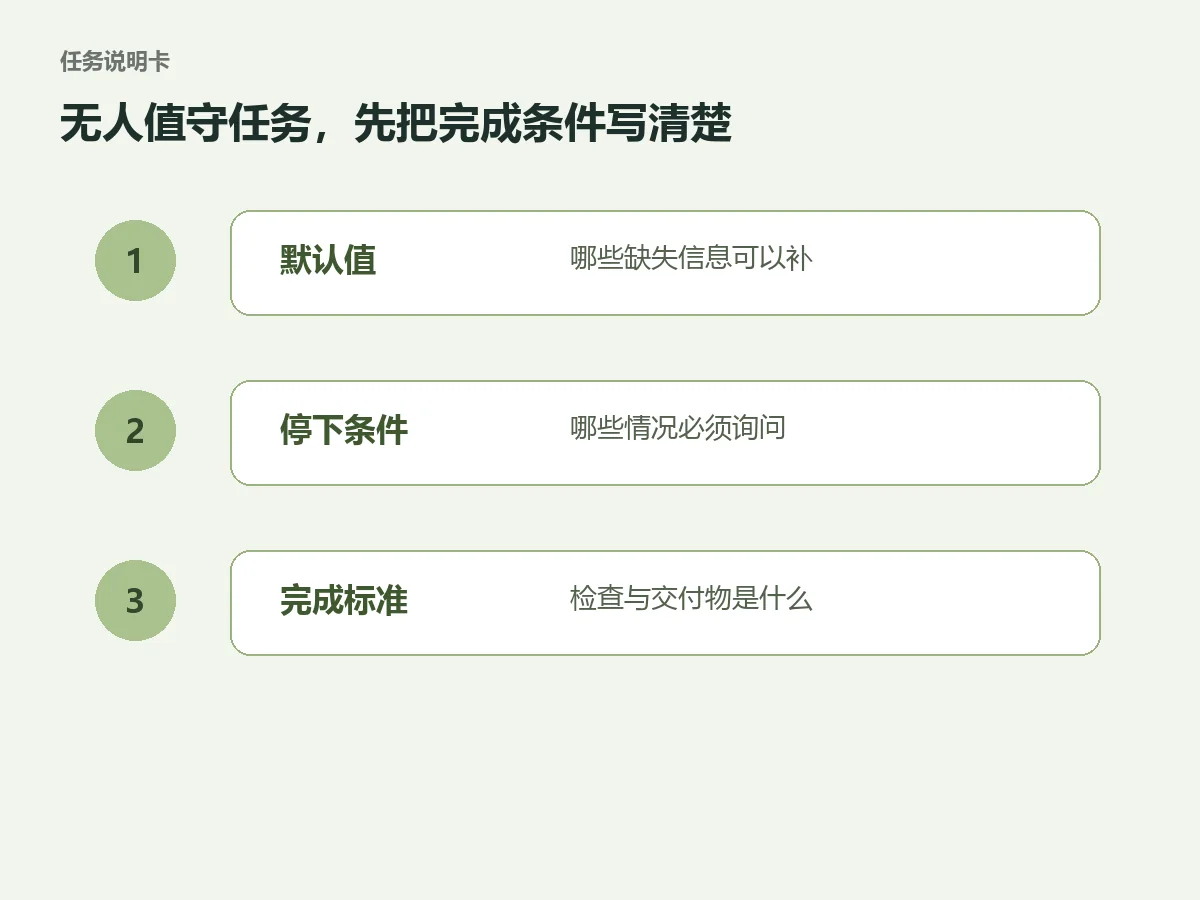
所以我会在提示词里补三件事:
- 哪些信息缺失时可以使用默认值;
- 哪些情况必须停下询问;
- 完成标准是什么,包括检查和交付物。
例如,不要只写“生成日报”,可以写成:“若日期未给出,使用Asia/Shanghai当天;数据缺失时标记缺失,不自行补数;生成表格和三条结论,通过总数校验后结束。”这比堆“认真、全面、专业”有效得多。
第三步:工具任务改用Responses API思路
官方迁移说明写得很明确:GPT-6 Astra虽然支持Chat Completions,但工具调用需要使用Responses API。迁移时还要移除不支持的temperature、top_p和top_logprobs等参数,避免请求因为旧配置直接失败。
Astra新增异步工具调用,可以在某个工具还在运行时继续推理、调用其他工具或回答独立部分。它也支持中途引导:用户在任务进行中补一条要求,系统可以保留已完成工作并继续。不过,这两项能力都需要应用端正确管理调用ID、挂起结果和WebSocket事件,不能只改模型名称就自动获得。
第四步:检查技能文件和隐藏指令
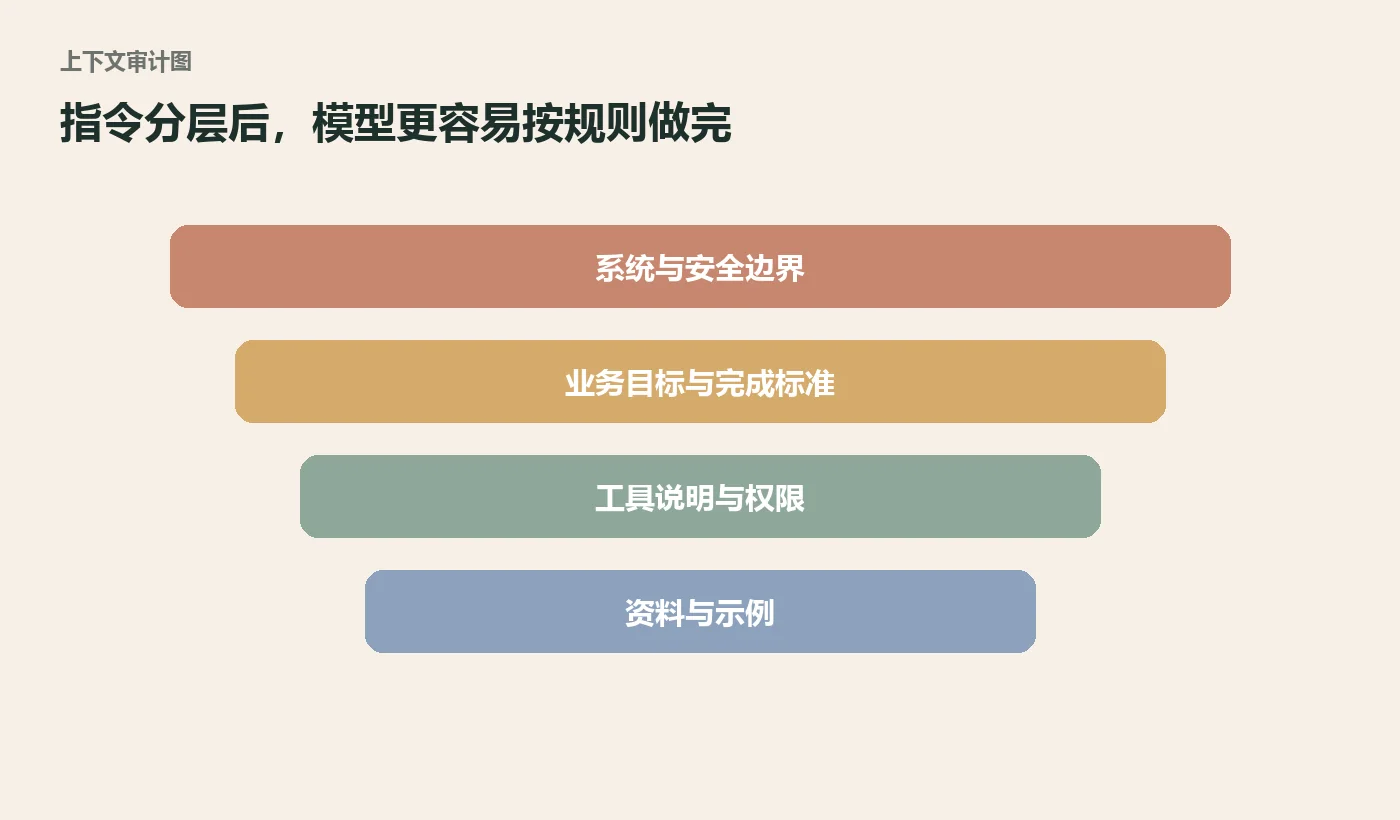
新模型更重视上下文中的指令,因此我会把系统提示、开发者提示、AGENTS.md、技能文件和工具说明一起审一遍。常见问题是同一件事在不同文件里写了相反规则,模型只好不断判断优先级,结果变得不稳定。
我的检查顺序是:
- 删除已经失效的流程和旧模型参数;
- 合并重复的风格要求;
- 给发布、删除、付款等动作单独写权限边界;
- 把长篇背景资料与真正必须遵守的指令分开;
- 用固定样例验证,而不是凭一两次聊天感觉。
一个可直接套用的提示词骨架
你可以先用这五段:角色与目标、可用资料、执行步骤、遇到缺失信息的处理方式、完成标准。写完后再删掉不影响结果的形容词。提示词越长不一定越好,关键是让模型知道什么时候继续、什么时候停、怎样证明已经完成。
迁移过程中,我会保留旧模型作为对照一段时间。等固定样例的质量、成本和延迟都达到目标,再扩大流量。这样出现问题时,能知道是模型、参数、工具还是提示词造成的。
常见问题
GPT-6 Astra可以用none推理档位吗?
不可以。官方模型页列出的档位是low、medium、high、xhigh和max。
旧的Chat Completions代码还能用吗?
基础对话仍支持,但官方说明工具调用需要Responses API。做代理或自动化时应按Responses API迁移。
升级后还需要保留原来的提示词吗?
建议保留一个基线版本,并按固定测试集逐项修改。一次改太多会失去可比较性。