如果你以前做过AI自动化,大概率写过这样一堆胶水代码:保存上下文、循环调模型、执行工具、处理超时、记录中间结果,再想办法让失败任务继续跑。OpenAI在2026年9月10日把Agents API推入公开测试,想把这套代理运行底座交给开发者托管使用。
我不会因为接口刚上线,就马上把最重要的生产流程全迁过去。更稳妥的做法,是挑一条范围窄、结果可检查、失败能重跑的任务,先验证会话、工具和恢复机制。
先弄清Agents API提供了什么
根据OpenAI官方公告,Agents API提供由OpenAI托管的Codex代理框架,负责长会话、上下文管理、工具调用和多代理协调。开发者可以选择OpenAI托管沙箱、自有基础设施或合作伙伴环境。
它和“调用一次模型拿回答”最大的区别,是任务可以持续更久,并在环境里运行代码、处理文件、保存产物。官方还提到自动上下文压缩、工具搜索、程序化工具调用和子代理并行等能力。
第1步:选一个窄任务
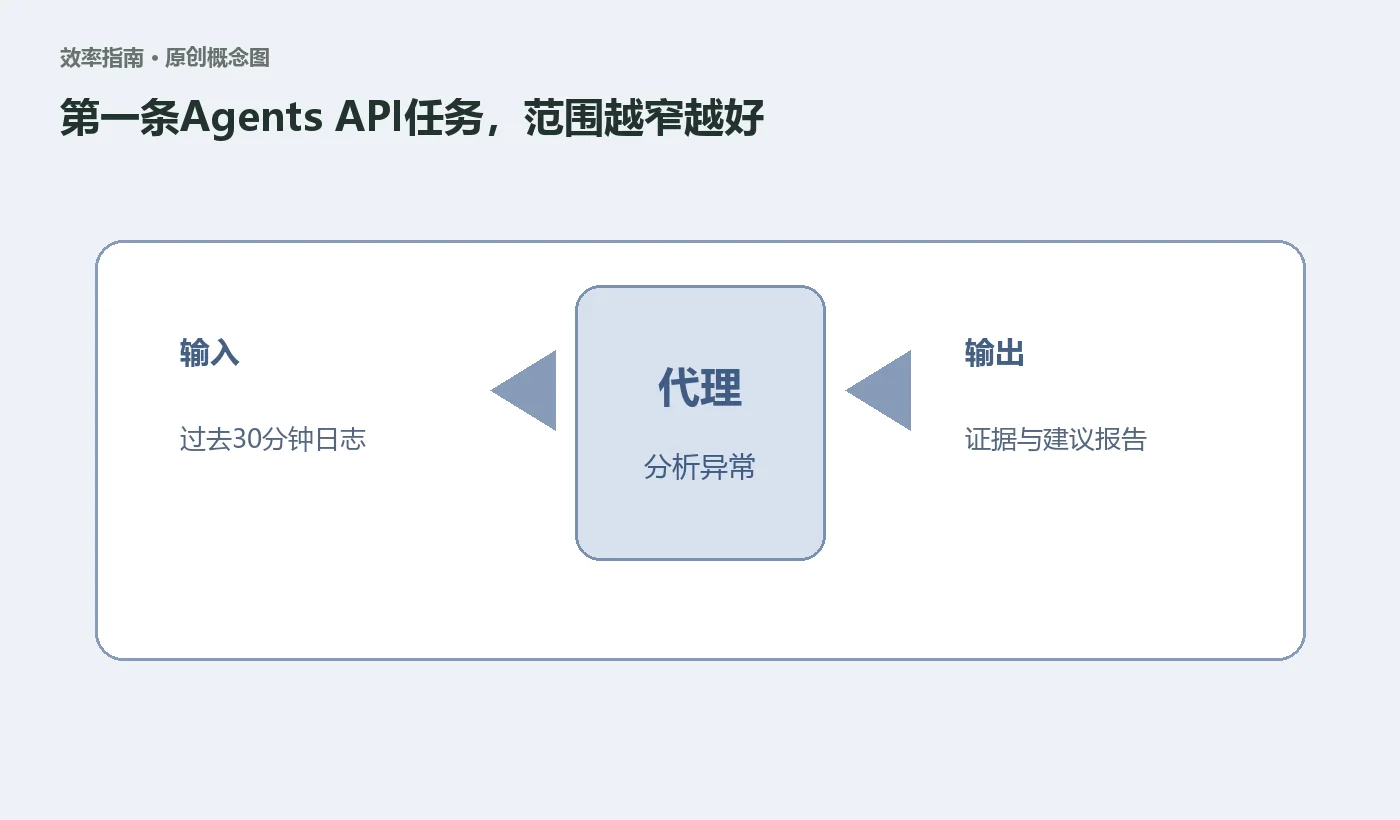
我会从“每天读取固定日志,找出异常并生成一份报告”开始,而不是“管理整个运维系统”。好的首个任务有四个特点:输入固定、工具少、完成标准清楚、失败不会造成不可逆后果。
先写一句验收标准,例如:“读取过去30分钟日志;列出5xx异常、证据与建议;缺数据时标记;不得自行部署;报告保存到指定目录。”这句话比十段人格描述更重要。
第2步:决定运行环境
| 环境 | 适合场景 | 需要确认 |
|---|---|---|
| OpenAI托管沙箱 | 快速开始、处理文件和代码 | 包、网络、密钥与费用 |
| 自有基础设施 | 数据和执行环境需要完全自管 | 资源隔离、升级和运维 |
| 合作伙伴环境 | 已使用对应云或沙箱平台 | 集成边界与计费方式 |
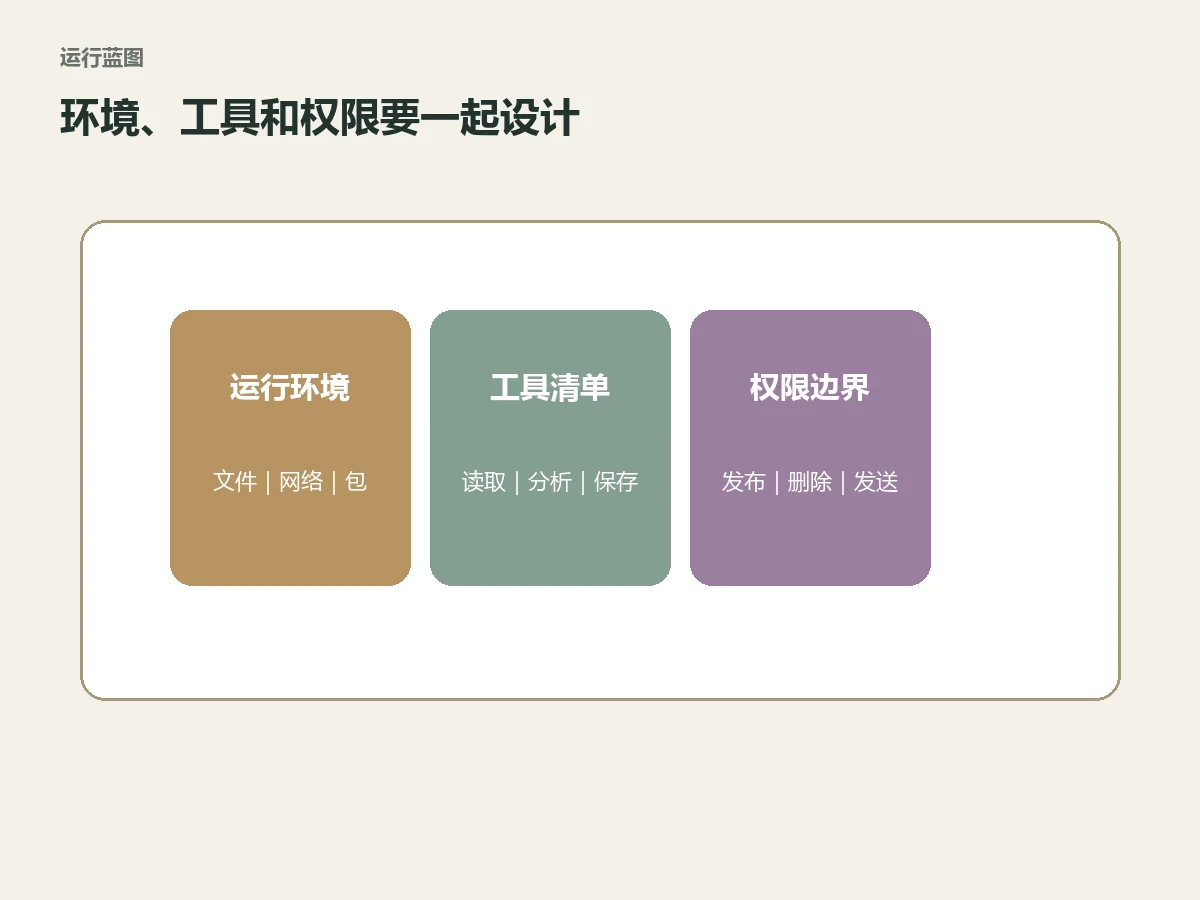
运行环境不是一个随手参数。任务要访问哪些文件、能否联网、密钥怎样注入、产物保存多久,都应该在上线前写成清单。
第3步:只接完成任务必需的工具
Agents API支持MCP、自定义函数和内置工具。我的原则很简单:第一版只给读取与分析工具,等结果稳定后再增加写入动作。能读日志的代理,不一定需要部署权限;能生成邮件草稿,也不一定需要直接发送。
工具说明要写清参数、返回值、失败状态和允许范围。否则模型即使选对工具,也可能因为边界含糊而反复尝试。
第4步:把会话状态和检查点设计好
官方API参考显示,创建会话时可以传入agent配置、环境、输入、元数据和vault等信息,会话会返回状态、错误、所需动作与用量信息。长任务不要只看最终文本,还要保存会话ID、关键步骤、输入版本和产物位置。
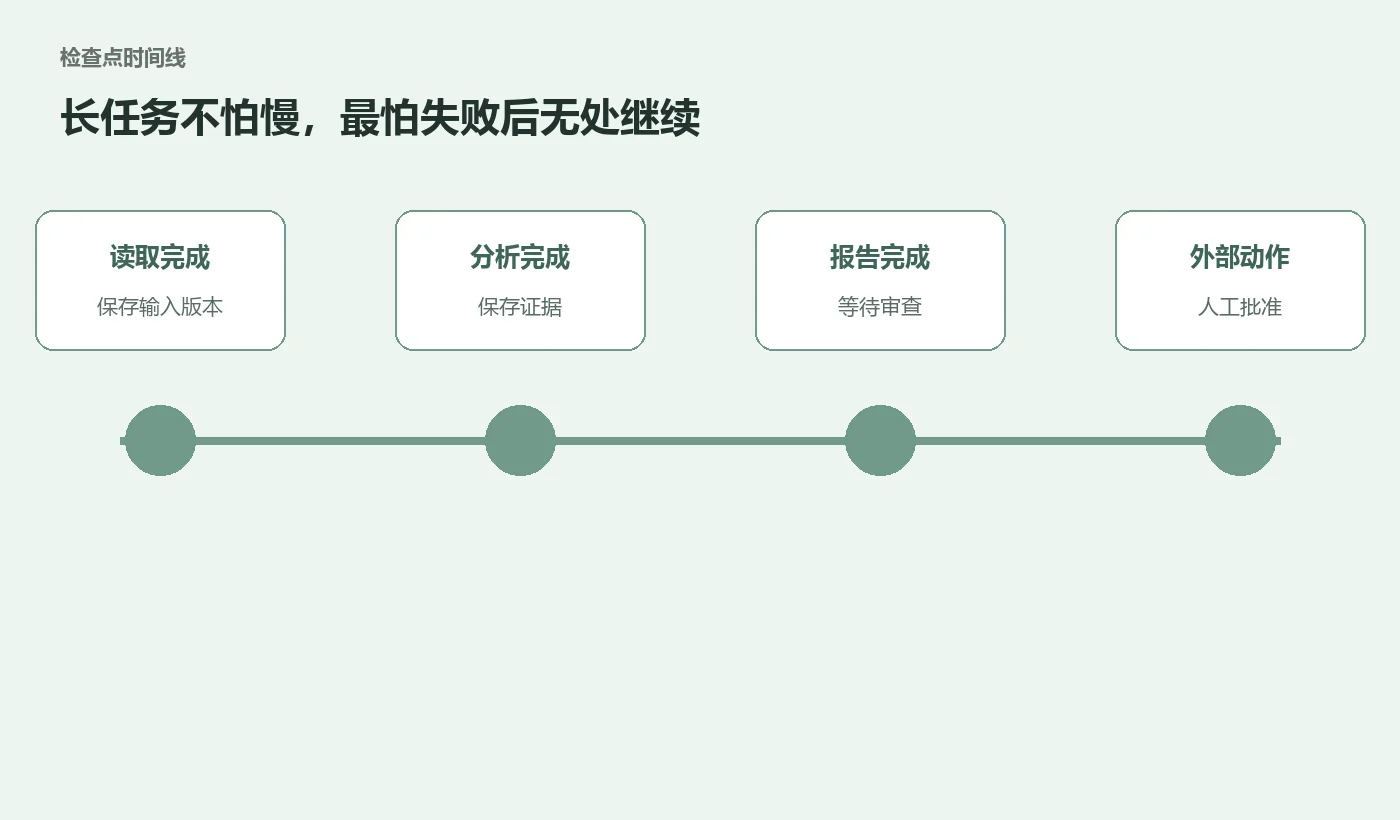
我会设置三个检查点:数据读取完成、分析完成、报告生成完成。任何一步失败,都从最近检查点继续,而不是重新跑全部任务。任务状态至少区分in_progress、requires_action、failed和完成结果,监控逻辑也要分别处理。
第5步:给高影响动作加人工审批
删除、发布、付款、改权限和对外发送,都应该有清楚的审批节点。代理可以准备内容、计算差异和生成预览,最后一步由有权限的人确认。审批记录要包含将要执行的动作、对象和主要变化,不能只显示一个“继续”按钮。
第6步:用失败场景测试
我会故意制造五种情况:工具超时、返回空数据、权限不足、用户中途改需求、会话跨过上下文限制。观察代理会停下、重试、请求帮助,还是在缺证据时硬猜。
测试指标至少包括完成率、人工介入次数、总耗时、令牌和工具成本、错误是否可恢复。公开测试期的接口和行为可能快速变化,版本、SDK和文档日期也要一起记录。
一段最小配置思路
官方示例通过client.beta.agents.sessions.create创建会话,配置模型、工具、环境和初始输入。实际代码应以你安装的SDK版本为准。第一版不要急着开很多子代理;先把单代理的输入、权限、日志和恢复跑顺,再比较并行是否真的节省时间。
常见问题
Agents API已经正式稳定了吗?
OpenAI在发布文章中把它称为public beta,也就是公开测试阶段。生产使用前要准备版本变化和回退方案。
使用Agents API需要额外平台费吗?
官方文章称Agents API本身不收额外费用,模型、工具和运行环境按对应价格计费。实际账单应以最新价格页为准。
我可以直接让代理自动发布或删除吗?
技术上取决于你提供的工具和权限。更稳妥的做法是先生成可审查预览,并为高影响动作保留人工批准。