一份摘要写得再顺,我也会多问一句:这话在原文件的哪一页?找得到,我才方便继续核对;找不到,复制进汇报的时候就容易心里没底。
我的建议很简单:让AI整理文档时,把结论、出处和不确定的地方一起要回来。摘要可以短,核对的路不能断。这篇就聊聊我会怎样安排这个流程,以及Claude API的引用功能能帮上什么忙。
资料核验:2026年9月8日。下面的功能说明依据Claude官方API文档,操作建议属于编辑判断,未进行本次接口实测。
我会先确认,手里的PDF是什么
同样叫PDF,里面可能是能选中文字的正文,也可能整页都是扫描图片。对人来说都能看,对引用机制来说却有区别。
Claude的引用文档说明:文本PDF可以返回基于页码的引用;纯扫描、没有可提取文字的PDF不能直接用于这套引用机制。普通文本和自定义内容则使用其他位置标记。
这里别把两个问题混起来:模型能否理解某个页面,与它能否通过指定机制给出可定位引用,需要分别确认。PDF支持文档和引用文档的用途也不同。
我的要求会写成这样
我会让摘要先回答一个具体问题,而不是把整份文件压成一段漂亮的话。例如:请找出文档里与交付日期有关的结论,每条注明出处;资料里没写的内容,请直接标注未找到。
接着,我会要求把原文事实与建议分开。原文只说“计划在年底前完成”,就不要整理成“年底前一定交付”。省掉几个字,意思可能差很多。
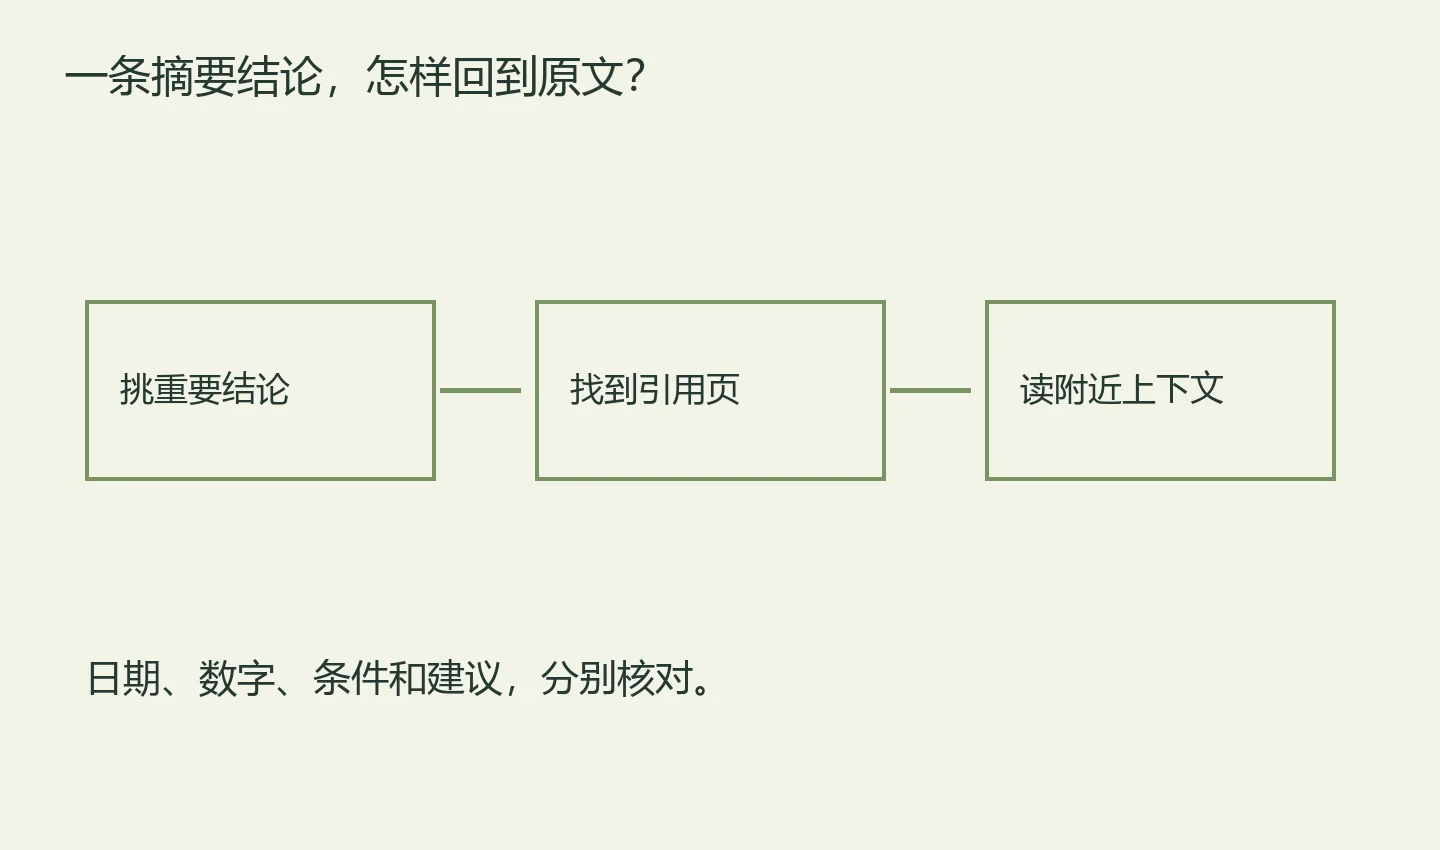
我会分三步检查
第一步:先挑重要结论
影响决策的日期、金额、限制和例外,我会优先核对。标题、背景介绍等内容可以稍后再看。这样即使时间有限,也能先检查最容易造成误解的部分。
第二步:回到原页读上下文
引用存在,不代表总结一定准确。我会把引用附近的几句话一起读,看看条件有没有被省掉,表格脚注有没有限制结论。
第三步:记录仍没解决的问题
同一份文件可能前后说法不同,也可能缺少关键附件。我会把这些问题列出来,不强行拼出一个听上去完整的答案。
| 检查项 | 我会追问什么 |
|---|---|
| 日期 | 是预计时间、截止时间,还是实际发生时间? |
| 数字 | 单位和统计范围有没有一起保留? |
| 条件 | 这句话适用于全部情况,还是某个特定场景? |
| 建议 | 这是原文要求,还是AI补充的判断? |
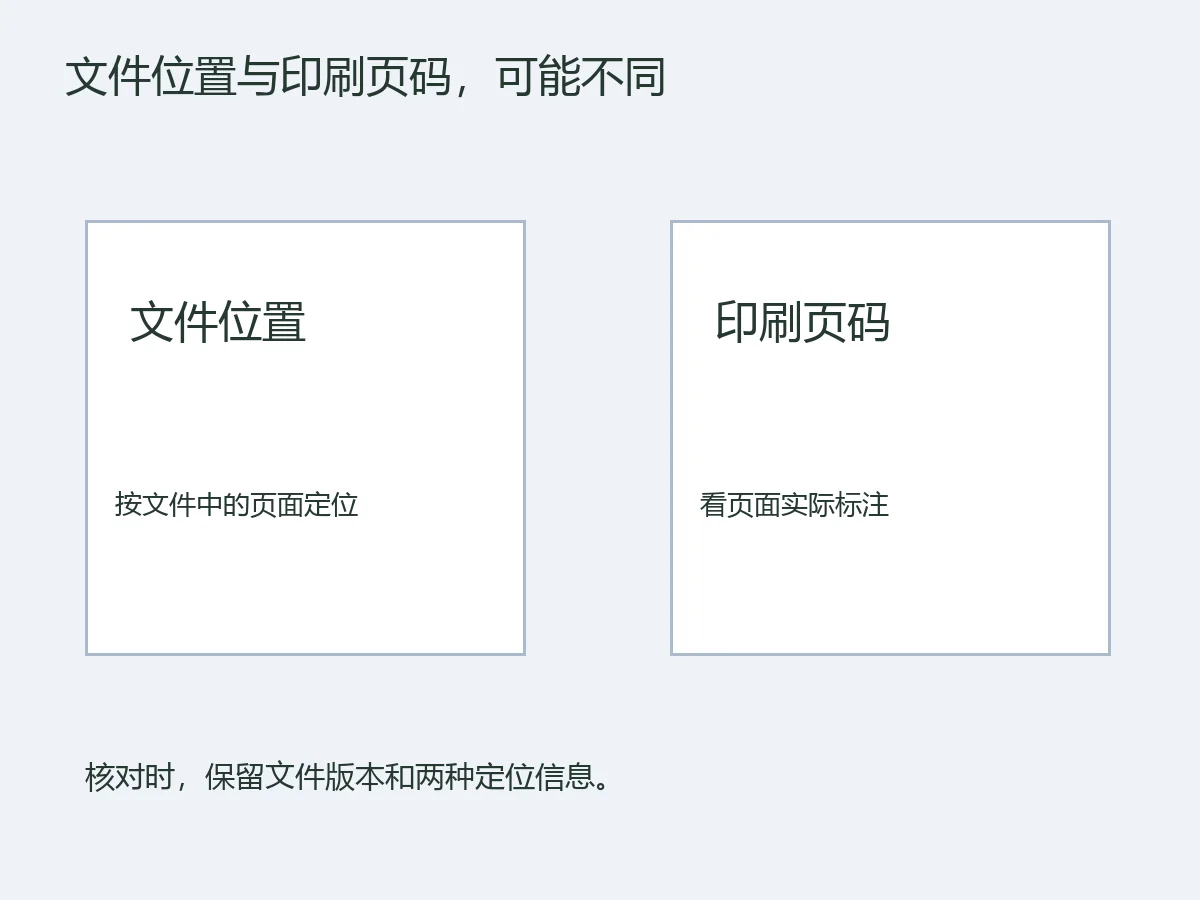
页码也可能让人找错地方
封面、目录和附录都会让文件中的页面位置与正文印刷页码不一致。我会同时记录系统给出的定位信息和页面上实际显示的页码。两者不同就写清楚,不凭感觉改成一样。
如果只是自己阅读,可以边看边记;如果要把摘要交给同事,最好保留文件版本。大家拿着不同版本找同一个页码,会白白多花一轮沟通时间。
你可能还想问
有引用就可以直接相信吗?
我仍会看原文。引用解决的是“从哪里查”,是否理解正确还需要核对上下文。
Claude聊天窗口也一定有同样的引用能力吗?
本文讨论的是官方API机制,不能直接推断所有聊天入口都提供相同设置或返回格式。以你正在使用的产品界面为准。
扫描件应该怎么办?
我会先准备可核对的文本版本,并检查文字识别是否出错。特别是小数点、单位和表格列,识别错误会一路传到摘要里。