评论越多,买家未必越容易选。看到一款车下面堆着几百条体验,大家仍然得自己找出空间、舒适度和使用上的顾虑。我读 CarMax 的公开案例时,最想拆的是这件小事:怎样把已有评论变成有用的摘要,同时让编辑接得住。
这是对2022 年公开案例的复盘,并结合微软 2024 年的组织实践介绍;资料核对于 2026 年 10 月 4 日。文中的业务成绩来自官方披露,我没有参与项目,也没有做同条件测试。
先看它究竟做了多大一件事
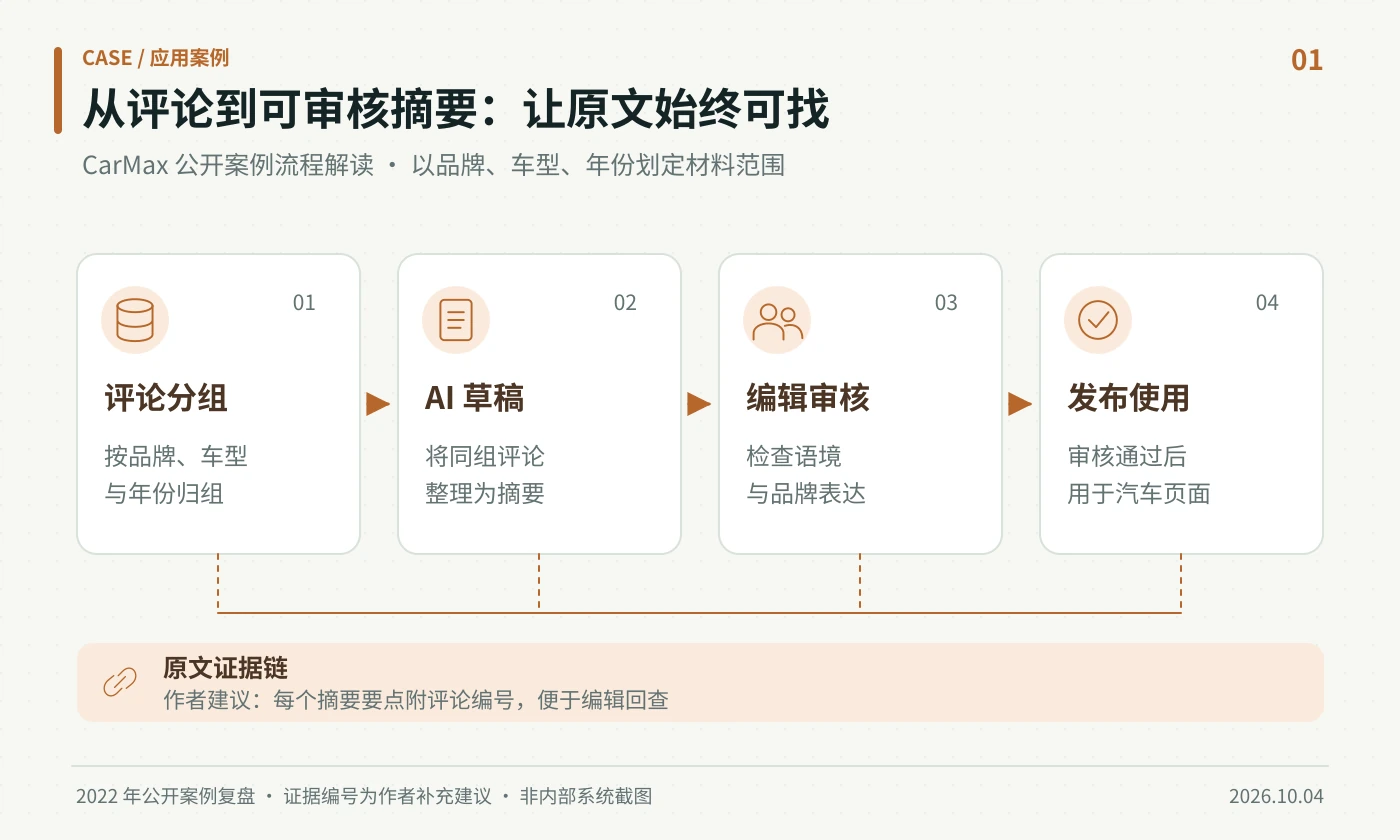
微软当年的报道说,CarMax 用模型把约 10 万条客户评论整理成约 5000 份摘要,按照品牌、车型和年份组织。这种颗粒度很重要:5000 指相应的车型年份组合,并非 5000 辆车各写一篇。来源:微软 2022 年报道。
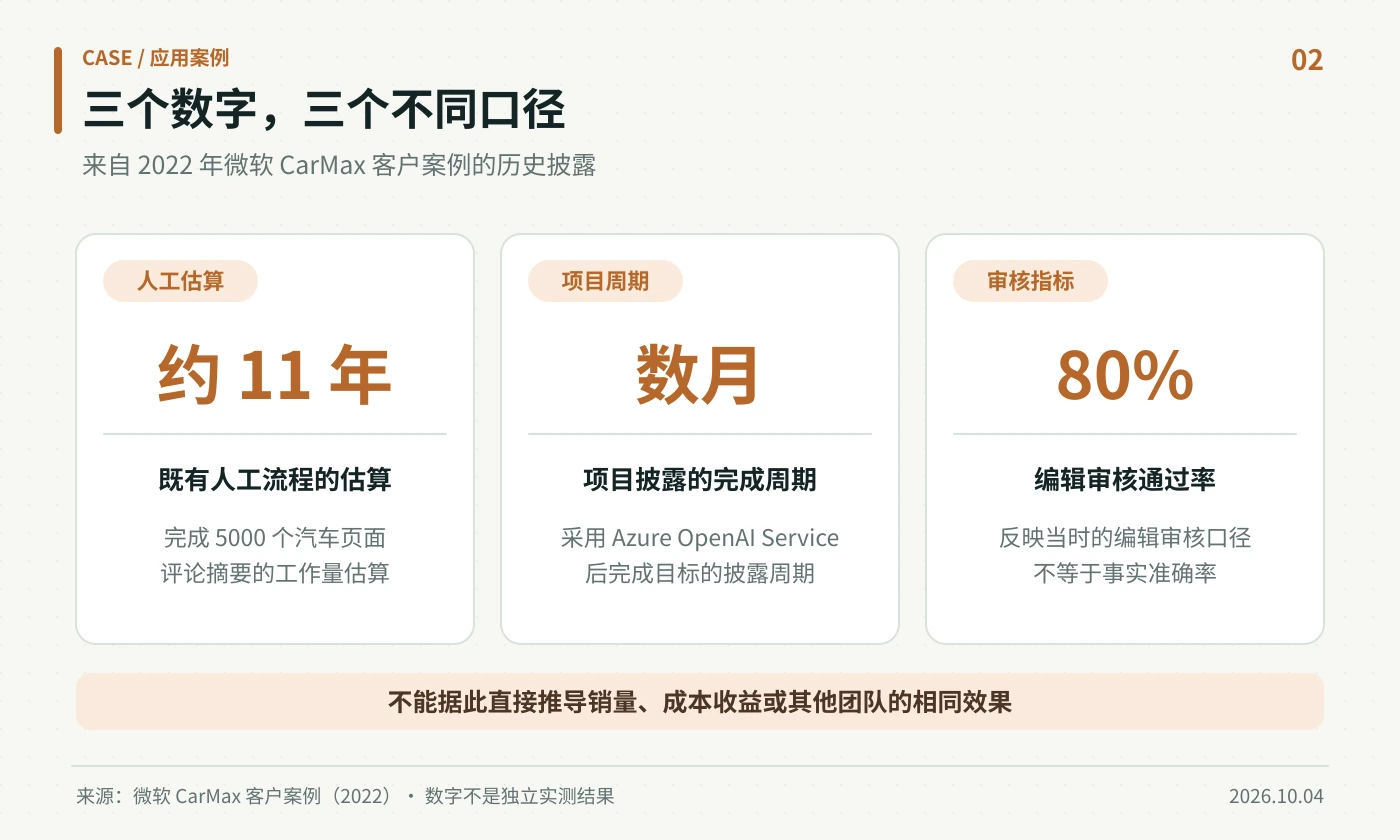
另一篇微软客户案例披露,CarMax 原本估算,按既有人工流程完成 5000 个汽车页面的评论摘要,需要约 11 年;采用 Azure OpenAI Service 后,数月内完成目标,编辑审核通过率为 80%。生成内容仍由员工检查语境和品牌表达。来源:微软 CarMax 客户案例。
我会把这几个数字分开读。11 年是当时的人工工作量估算,数月是项目披露的完成周期,80% 是编辑审核口径。它们不能直接换算成事实准确率,也不足以证明销量提升了多少。公开材料没有给出完整成本、统一的盲测方案或可复现的审核标准,所以我不会据此替别的团队承诺同样收益。
我觉得最值得借鉴的是“先缩小摘要单位”
把某个品牌的全部评论交给 AI,往往连人都很难验收。新旧年份的配置可能不同,某位车主的感受也不能变成所有车辆的保证。CarMax 的案例给我的启发是:先把要服务的页面定义清楚,再决定哪些材料能进来。
如果换成一家卖家电的小团队,我会先选同一产品、同一代际的一组评论,记录来源编号、时间和适用型号。维修记录、参数表和用户主观体验分别保存;摘要要说参数时,回到正式产品资料核对。缺少可靠材料的项目,暂时留空比补上一句顺口的评价更容易维护。
给模型的任务可以写得很窄
例如:仅根据所附评论写两句摘要,一句概括反复出现的使用体验,一句保留值得注意的分歧;每个要点附评论编号。不要推断故障率、销量或未提供的配置;证据不足就说明不足。这是我建议的任务模板,并非 CarMax 公开使用过的提示词。
人工审核要知道自己在查什么
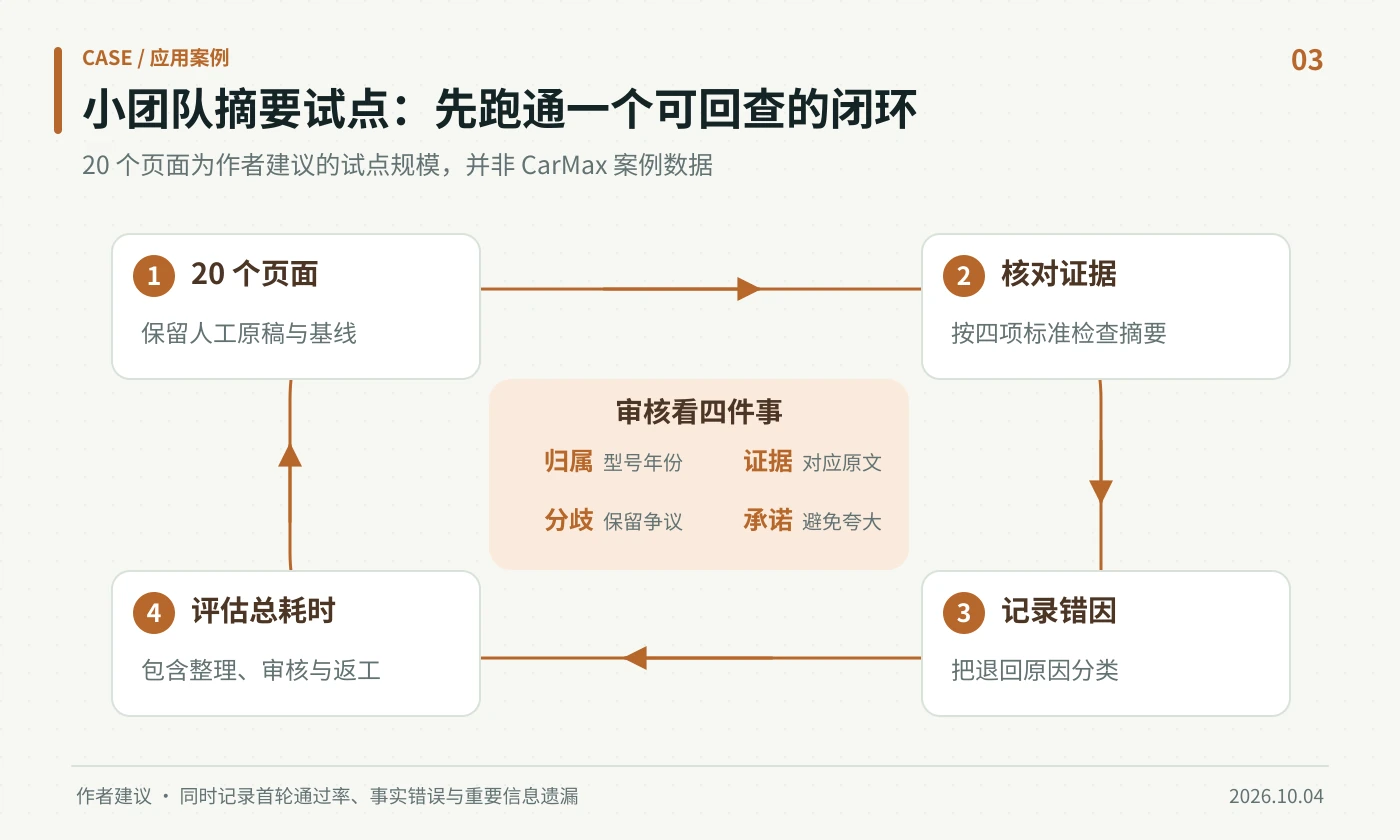
“读起来挺好”很难成为稳定标准。我会让编辑按下面四项检查,把退回原因记下来:
- 归属:有没有把其他型号、年份的内容混进来?
- 证据:摘要里的每项判断,能不能找到对应原文?
- 分歧:少数人的抱怨有没有被说成普遍缺点,真实争议有没有被抹平?
- 承诺:有没有把体验描述写成性能、安全或售后保证?
这样,一条退回记录就能指向具体改进:材料分组有错就修数据,表达夸张就改规则,证据不足就减少输出。编辑不用每次从头解释什么叫“更准确”。
小团队先跑一轮,别只数生成篇数
微软在 2024 年的介绍里,还提到 CarMax 的跨职能小团队、AI 治理机制,以及持续更新的数据基础。这个补充让我更在意上线后的维护:谁负责资料更新,谁能决定扩量,谁来处理出错的页面。来源:微软 2024 年组织实践介绍。
我会从 20 个有代表性的页面开始。这是建议的试点规模,不是案例数字。保留人工原稿,对比资料整理、生成、审核和返工的总耗时,同时记录首轮通过率、事实错误和重要信息遗漏。若省下的写作时间都花在核对上,就先找错因,暂不扩量。
对内容团队来说,这个老案例到今天仍有参考价值:找一批边界明确、来源可追溯的重复任务,让 AI 先完成草稿,再用可执行的审核标准决定能否发布。最后留下来的,应该是一套能持续维护的内容流程。
资料来源与核验说明
- 微软客户案例:CarMax 的汽车研究内容实践,2022 年 5 月 24 日,提供人工估算、完成周期及编辑审核数据。
- 微软报道:Azure OpenAI Service 与 CarMax 评论摘要,2022 年 5 月 24 日,提供评论量、摘要量和组织方式。
- 微软博客:CarMax 如何组织和扩大 AI 创新,2024 年 1 月 22 日,补充团队、数据和治理背景。
核验日期:2026 年 10 月 4 日。本文为公开案例解读与作者建议,未将历史披露当作当前业务规模或独立实测结果。