看到“商家最近生意下滑,明天沟通该讲什么”,AI 很容易立刻给出打折、投广告、换套餐的建议。但我读完 Grab 的 Jarvis Pro 案例,更在意它有没有先弄清:问题到底出在流量,还是门店根本没有正常接单?
本文依据 Grab 于 2026 年 8 月公开的工程文章整理,资料核对截至 10 月 3 日。它是一家真实公司的内部助手案例;我没有接触其后台,也不会把公司的自述当作独立实测。
先看清这个助手服务谁
Jarvis Pro 面向 Grab 的商户客户经理,帮助他们准备经营沟通。Grab 在8 月 21 日的工程复盘中提到,早期系统曾在门店暂停接单、履约变差时建议加促销。团队随后把任务分类、范围确认和证据选择放在回答之前。这比一句“帮商家增长”更能说明产品解决的具体问题。
从使用者角度看,“明天见客户”包含好几层任务:确认是哪家商户、比较什么时间段、解释哪个指标,再决定谈什么。把它们挤进一次自由回答,任何一层猜错,后面的文字都可能跟着偏。
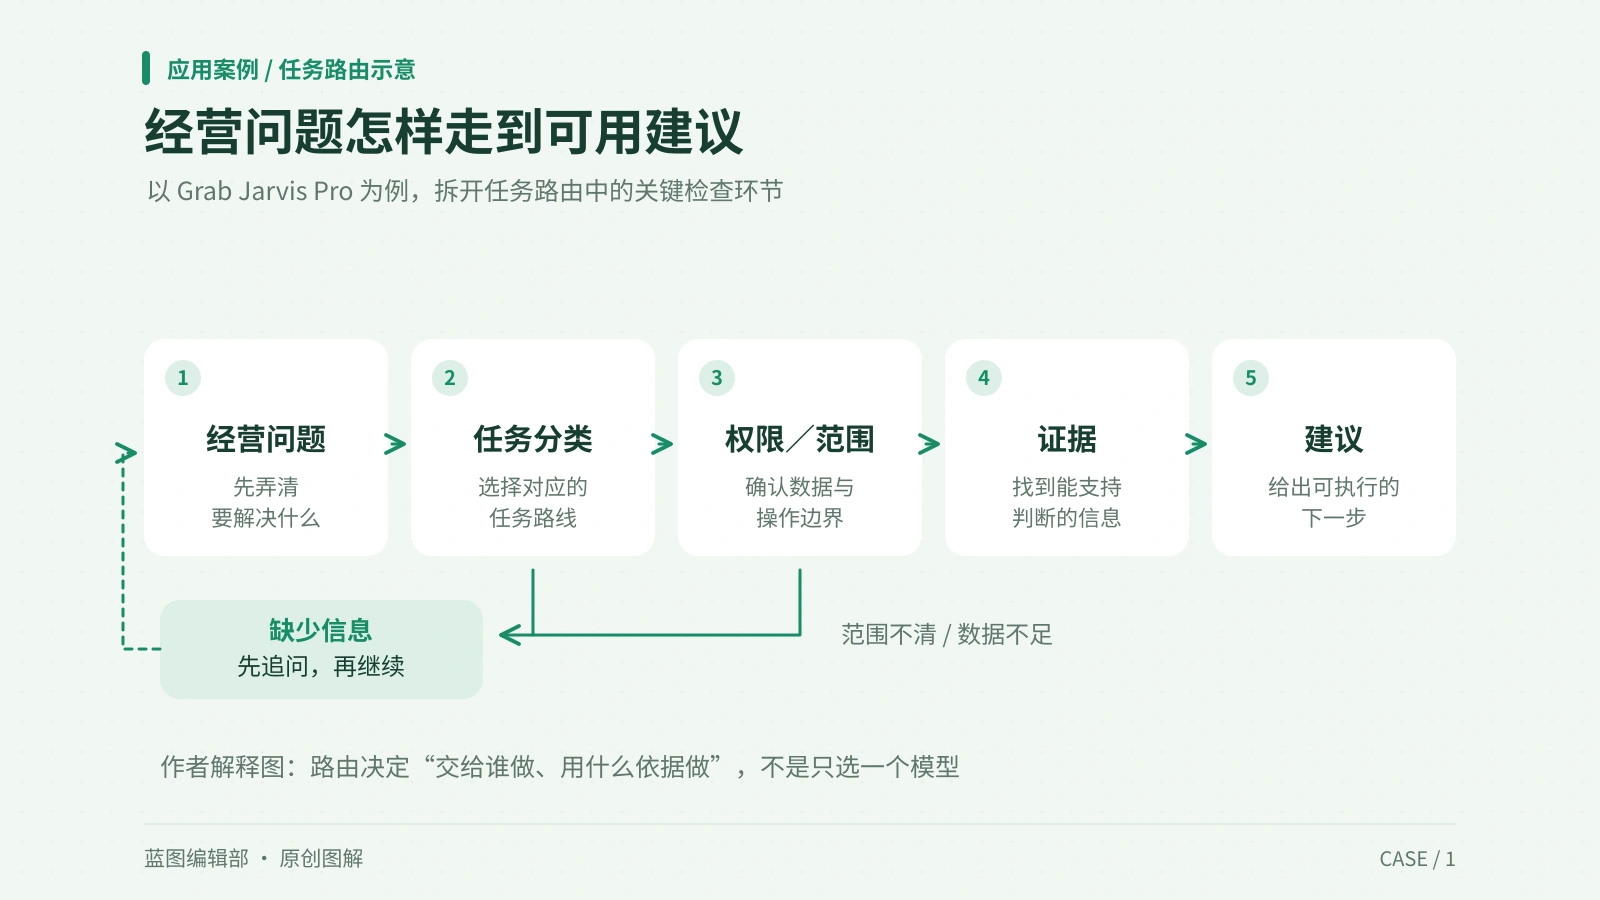
我会把它理解为一道回答前的分流题
这里的“路由”,可以理解成先决定问题交给哪条处理流程。经营复盘、广告总结、权限外请求,需要的资料与回答方式不同。读者不必照搬 Grab 的技术栈,也能借用这个思路。
例如做一个门店助手,我会先写三张很短的任务卡:销售变化看订单与客单价;经营障碍看营业状态与履约;活动复盘看投放与活动结果。每张卡写明允许使用的数据、缺了什么必须追问,以及谁来确认建议。这里是我的设计建议,并非 Grab 公布的产品配置。
任务卡还有一个好处:业务同事可以直接指出分类哪里不对,不必等模型生成几千字,再从里面找错误。一次追问虽然多花几十秒,往往比客户会上解释错数字更划算。
99.4% 这个数字,要连着分母一起读
Grab 披露,在 351 条现实风格提示词的内部离线评估中,99.4% 选择了可接受的安全路线。这个定义包含准确或语义等价且安全的路线,不能改写成“经营建议正确率 99.4%”,更不能当作上线后的增收比例。原文明确说,这类评估用于上线准备,不证明商业收益。
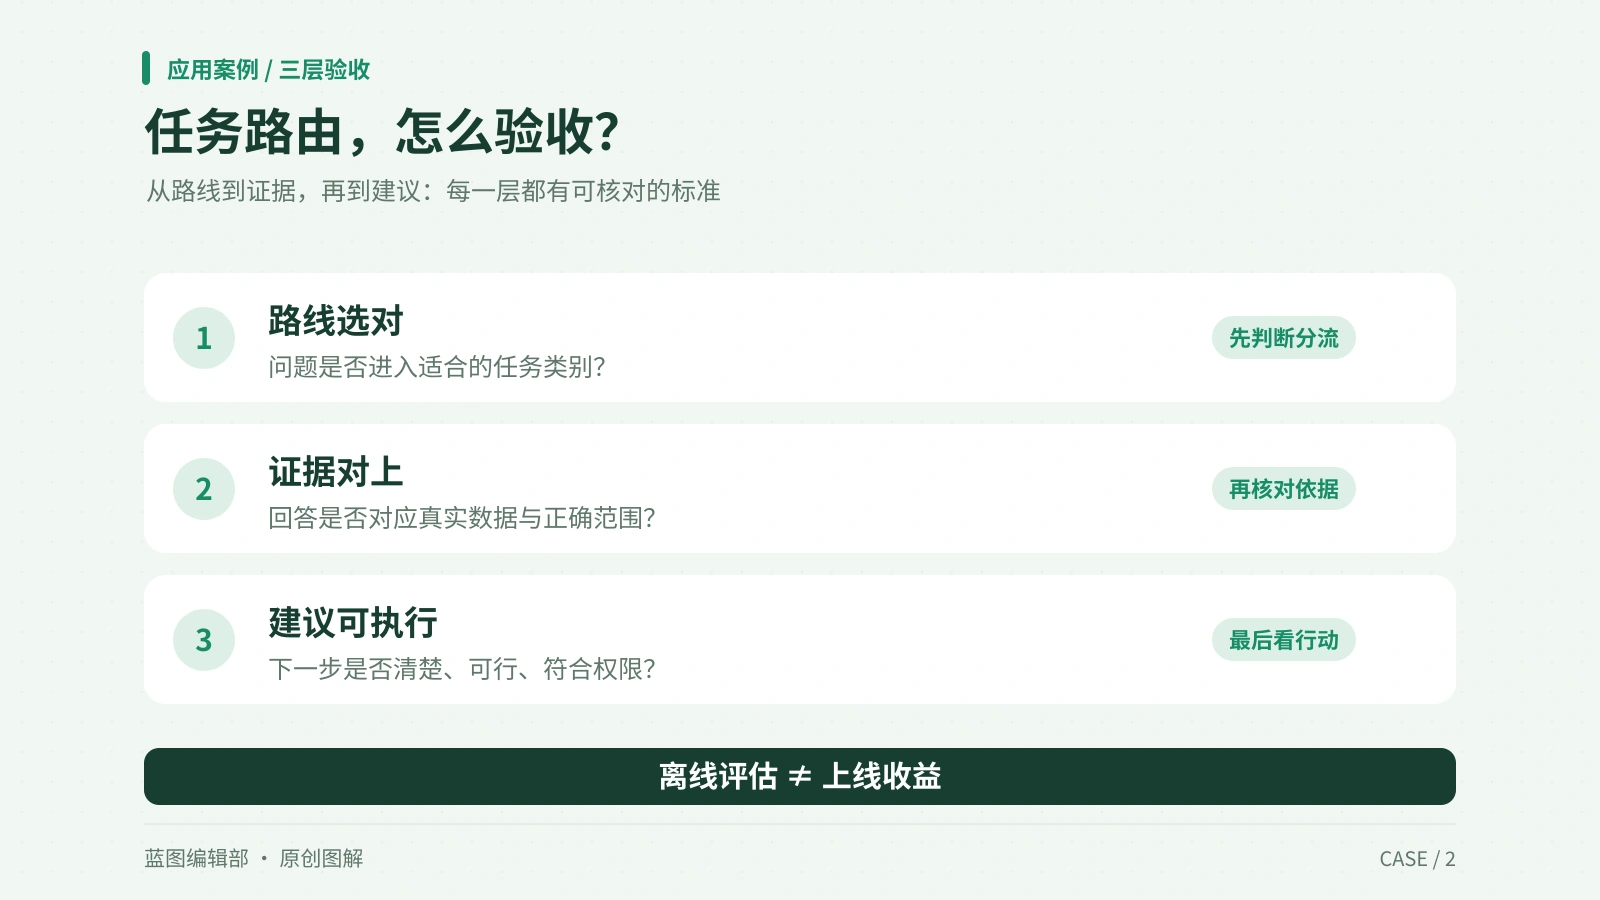
我会把验收拆成三个问题:路线是否适合任务,引用数字能否对回原始记录,建议能否在当前条件下执行。假如促销建议很漂亮,但门店没有足够接单能力,最后一关仍然该判失败。综合分可以帮助比较版本,却不能替代这些具体检查。
数据口径和失败记录,也属于产品本身
这并非孤立的设计。Grab 在8 月 1 日的分析体系文章里,将指标定义、适当粒度和可信上下文列为基础,并保留人工对业务判断的责任。我读到这里的提醒是:销量、实收与结算金额,本来就不能随便互换;先把口径确认好,模型才有条件解释差异。
另一篇Grab Bench 官方介绍强调逐条保存评估结果和失败类型,也明确合成评估不能证明生产环境收益。对小团队来说,这一点尤其容易低成本借鉴。记录“商户认错”“月份选错”“来源过期”,比只写“回答不够好”更有助于下一次修正。
如果由我设计试点,会从 20 个问题开始
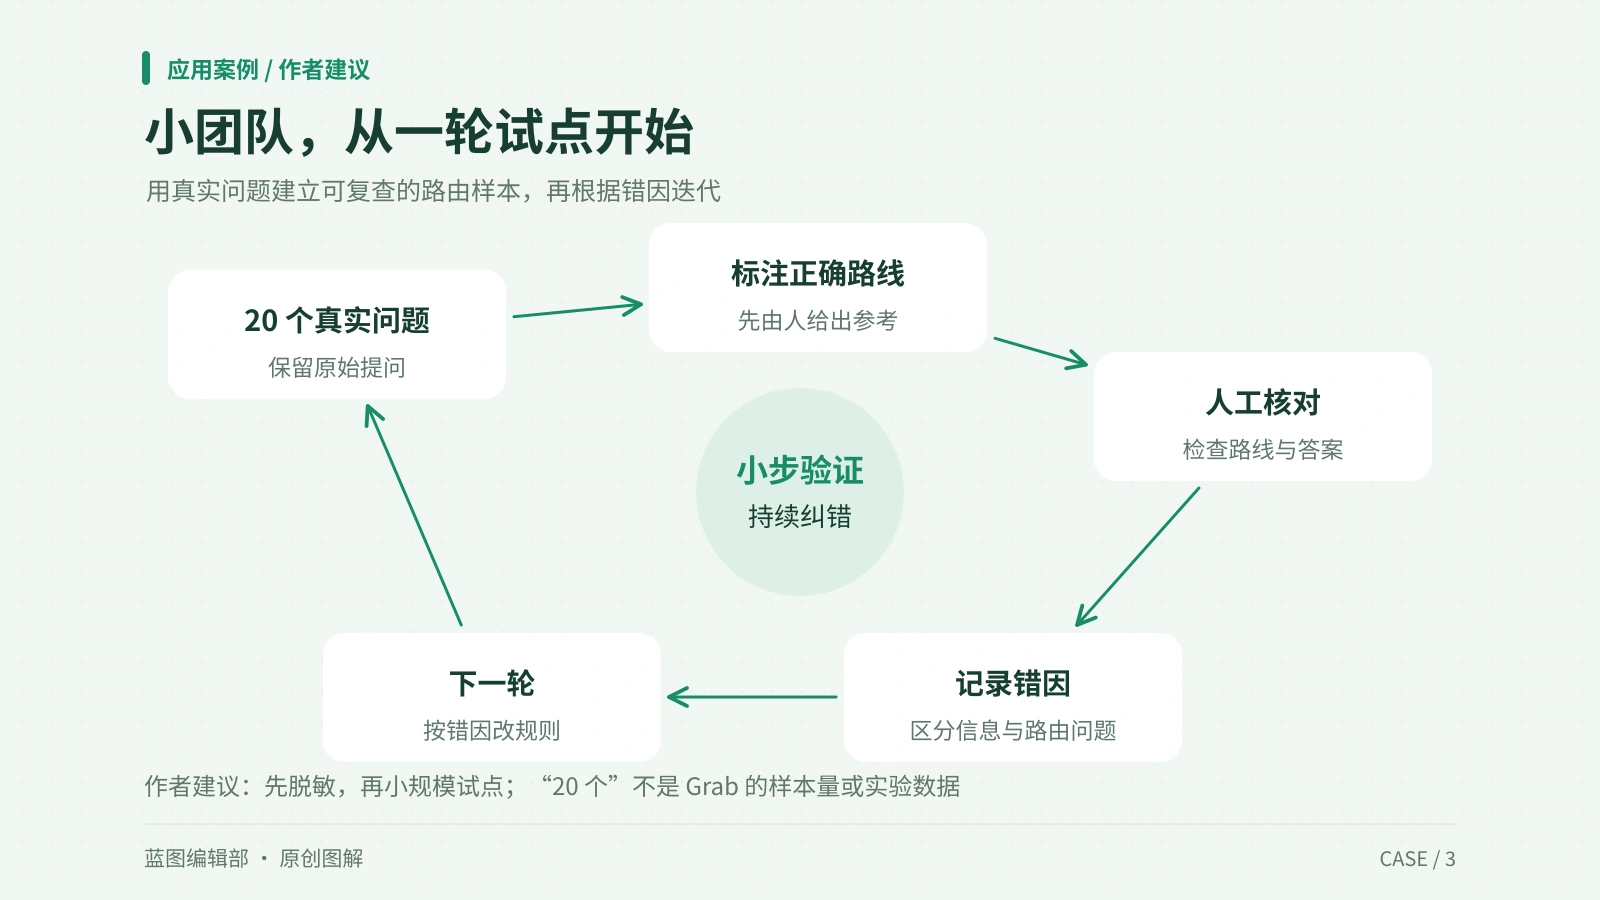
我的建议是找 20 个经过脱敏的历史问题,覆盖常见请求、缺少条件和越权请求。20 只是便于启动的建议规模,不是 Grab 的测试集大小。请一位熟悉业务的人先标注正确任务、所需证据及应当停止回答的条件。
试点时,我还会故意放入两个容易混淆的商户名称、同一指标的不同版本,以及一条没有完整时间范围的提问。预期答案未必是一段建议,也可能只是请用户补充信息。把“该追问时有没有追问”单独计数,才能避免团队把积极回答误当成可靠表现。权限边界应交给业务系统落实,不能只在提示词里写一句“请保密”。
接着让助手只生成内部草稿,由负责人逐项复核。记录每次错在哪里、复核花多久、有没有减少重复查资料,再决定是否扩大范围。尤其要单列“建议被采纳后发生了什么”;回答速度、采用率和实际经营结果是不同指标,不宜合成一句“效率大幅提升”。
这个案例让我更愿意问供应商一个朴素的问题:当材料不全、指标冲突或对象不明确时,你的助手会怎么处理?能把这些情况讲清楚,才比较接近可以交给业务团队长期使用的工具。
来源说明:以上事实来自 Grab 自有工程博客,属于企业公开自述;文中的任务卡、三层验收和小规模试点方案为作者分析,不代表 Grab 的实际部署细节。