AI安全新闻很容易只剩一句“风险变大了”。我读Anthropic在2026年9月发布的最新威胁情报报告时,更关心它到底观察到了哪些行为、时间范围多长,以及公司采取了什么处置。
报告覆盖2025年12月至2026年8月。Anthropic称,其威胁情报团队识别并中断了利用Claude开展恶意活动的行动,并在适当情况下与执法机构和行业伙伴共享情报。公开案例来自Anthropic自身监测,无法代表整个AI行业的完整规模。
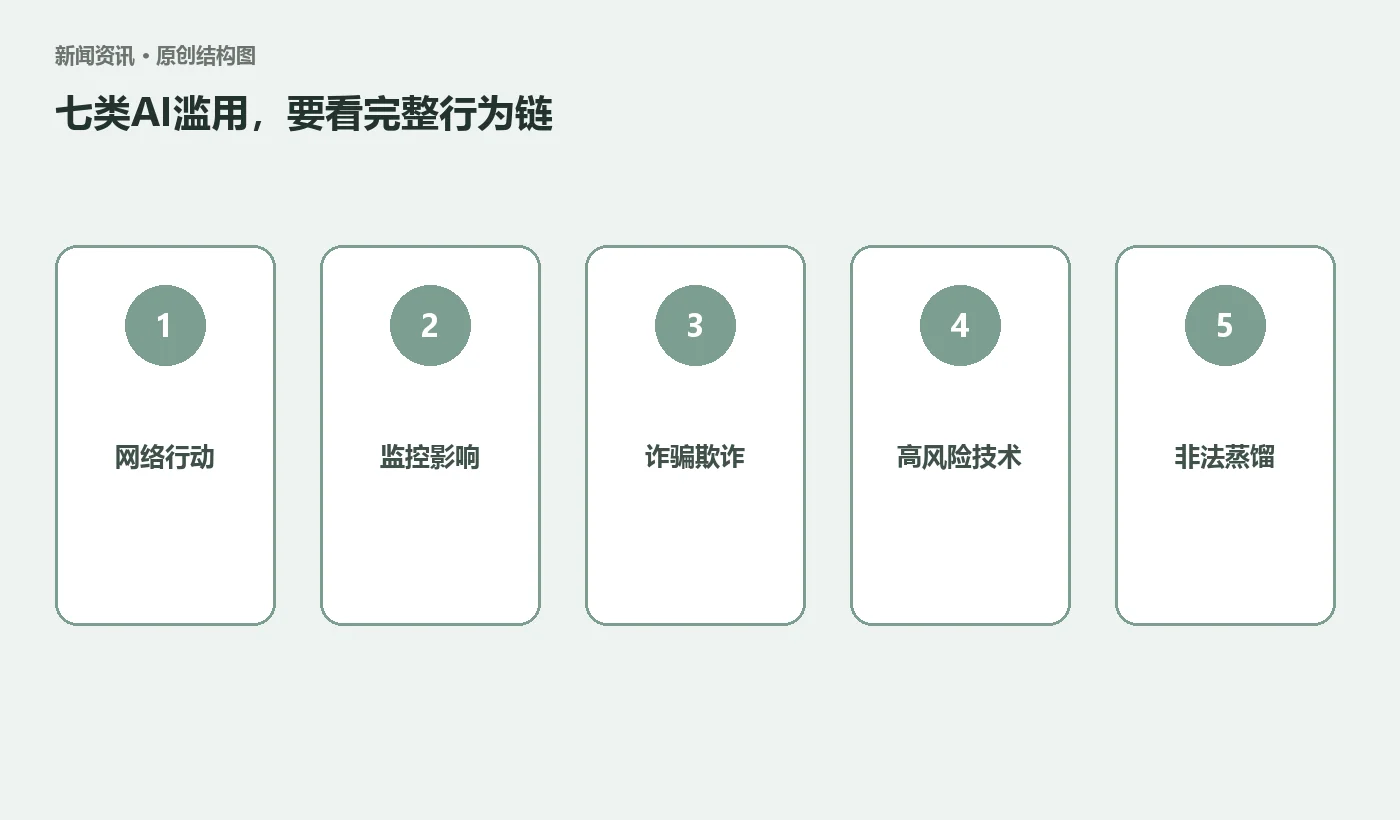
七类风险分别是什么
根据Anthropic报告主页,内容覆盖网络行动、监控行动、影响行动、常规武器、生物滥用、诈骗欺诈和非法蒸馏。
| 类别 | 可能利用AI的环节 | 我会关注的防护 |
|---|---|---|
| 网络行动 | 侦察、脚本、漏洞流程 | 权限、行为监测、封禁 |
| 监控与影响 | 汇总信息、生成内容 | 来源追踪、异常账号 |
| 诈骗欺诈 | 话术、批量沟通 | 身份核验、付款确认 |
| 高风险技术 | 生物与武器相关协助 | 能力分级、专业审查 |
| 非法蒸馏 | 批量调用复制模型能力 | 速率、模式和账号关联 |
我看到的变化:模型被放进更长的流程
过去谈滥用,常把模型想成“生成一段危险文字”。现在更需要检查完整链条:账号从哪里来、调用频率是否异常、模型是否反复使用工具、输出是否被接到外部系统。
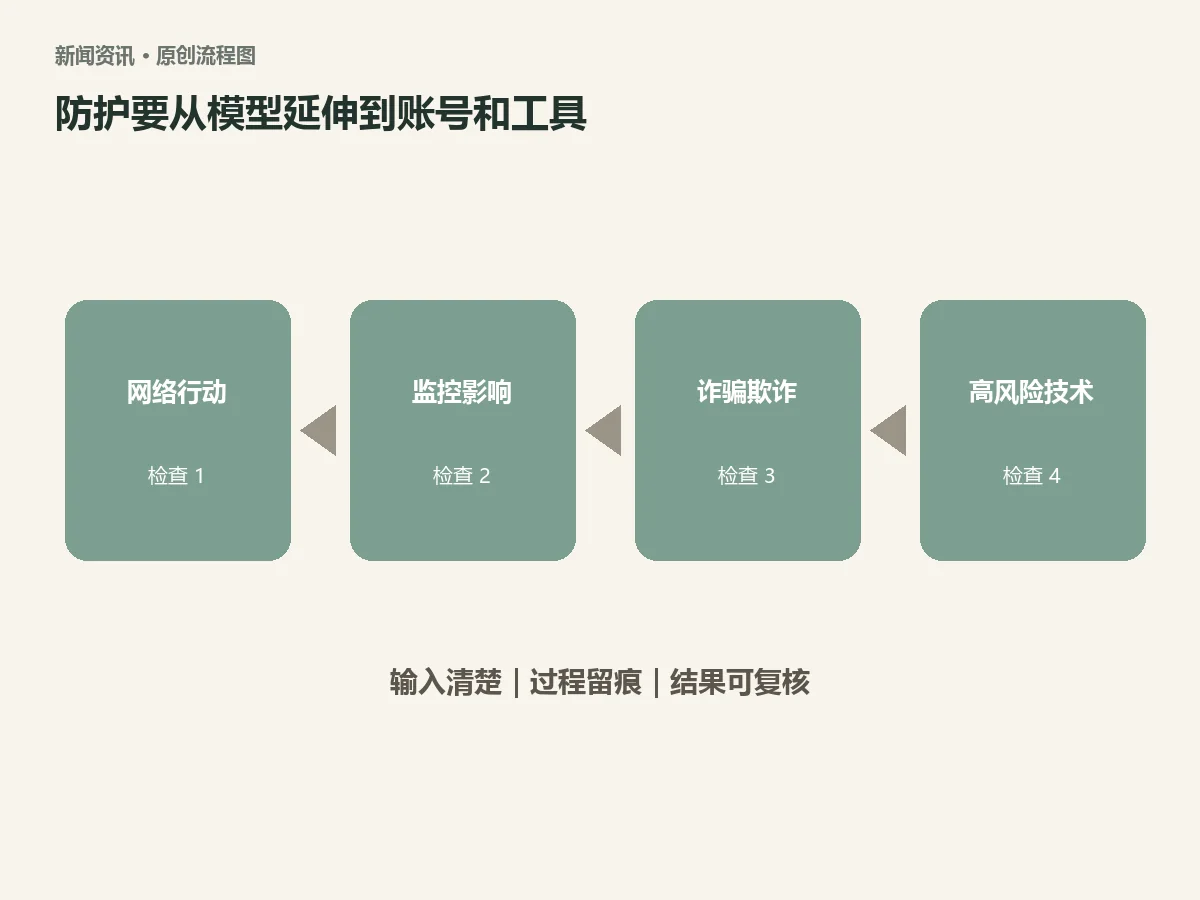
单次提示词过滤只能挡住一部分问题。真正有效的防护通常要把模型判断、账号行为、付款与身份信号、工具权限和人工调查连起来。报告也强调,中断活动之后还要把经验反馈进安全措施。
普通用户和团队能做什么
我会先做四件很朴素的事:重要账号启用多因素认证;对付款、改权限和批量发送保留人工确认;限制代理可用的工具和数据;保存异常调用与操作日志。
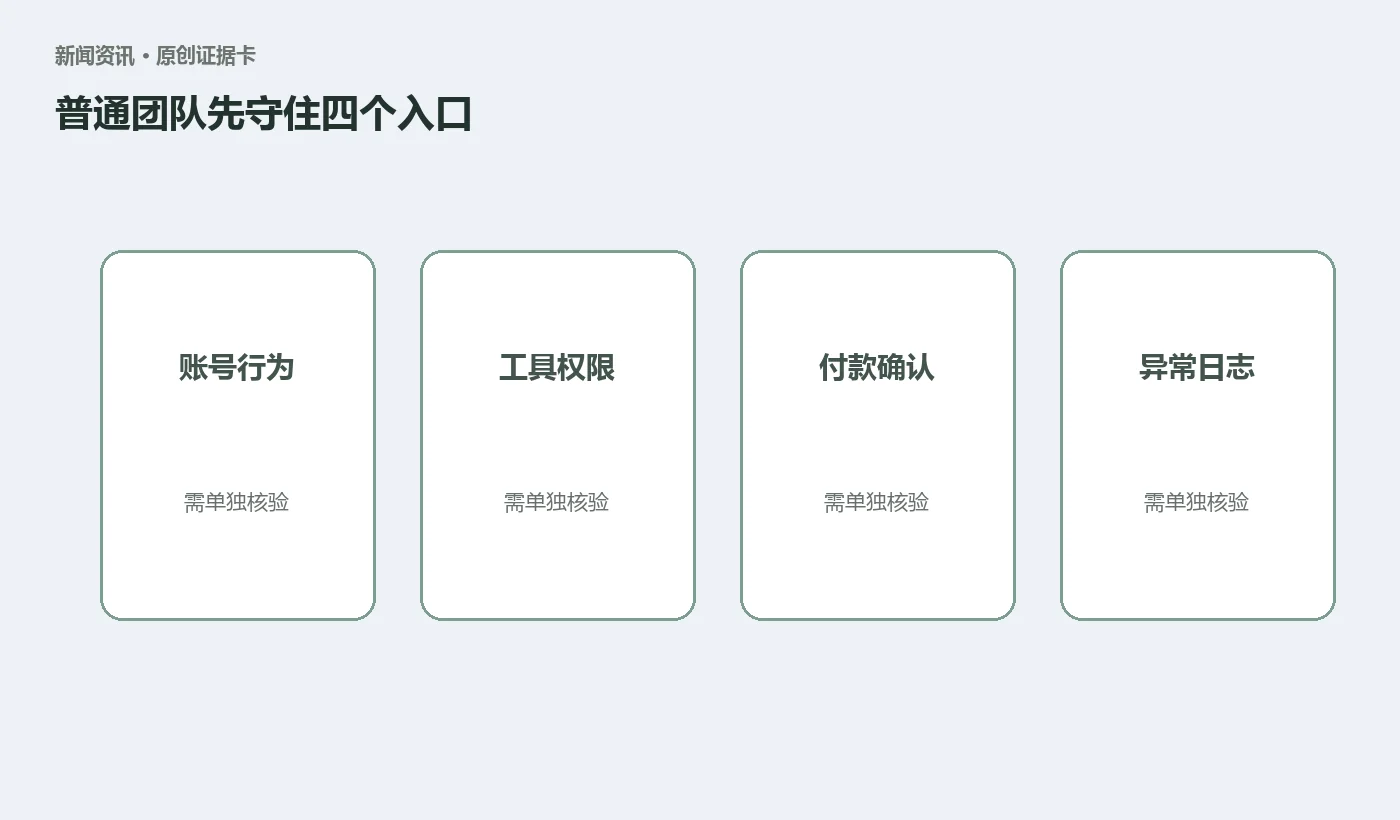
内容团队还要提防“隐藏指令”。网页、文档或邮件里的文字可能诱导代理泄露数据或执行额外动作。把外部材料当资料读取,不把其中的命令自动当授权,会安全很多。
报告不能证明什么
报告没有给出所有事件的完整原始数据,也无法说明Claude在恶意AI活动中的市场占比。被发现的案例会受到监测能力和披露政策影响,因此不能用案例数量直接比较不同厂商安全水平。
它能提供的价值,是把滥用方式和处置思路公开出来,让其他平台、研究者和用户更早识别类似模式。
常见问题
报告是否说明Claude本身被攻破?
报告主题是威胁行为者尝试利用Claude开展恶意活动,不能简单等同于模型或平台遭到系统入侵。
Anthropic采取了哪些动作?
官方称已中断相关活动、加强防护,并在适当情况下与有关部门和行业伙伴共享情报。
普通用户最优先做什么?
先保护账号和高影响动作:多因素认证、最小权限、人工确认和日志留存。