我们平时打开ChatGPT,只会感觉它“回得快不快”。但一次登录、读取设置或新建对话,背后可能要做很多次数据查询。任何一个关键查询变慢,前端都会跟着卡;存储服务出问题,产品甚至会直接不可用。
OpenAI在2026年9月11日第一次公开介绍Habitat在线存储平台。官方给出的规模很醒目:每秒处理超过7000万次请求、服务每周超过10亿用户、覆盖接近40个地理区域,并管理500PB以上数据。这篇文章是工程团队对自家系统的技术复盘,数据来自OpenAI,外部无法独立复现全部生产环境。
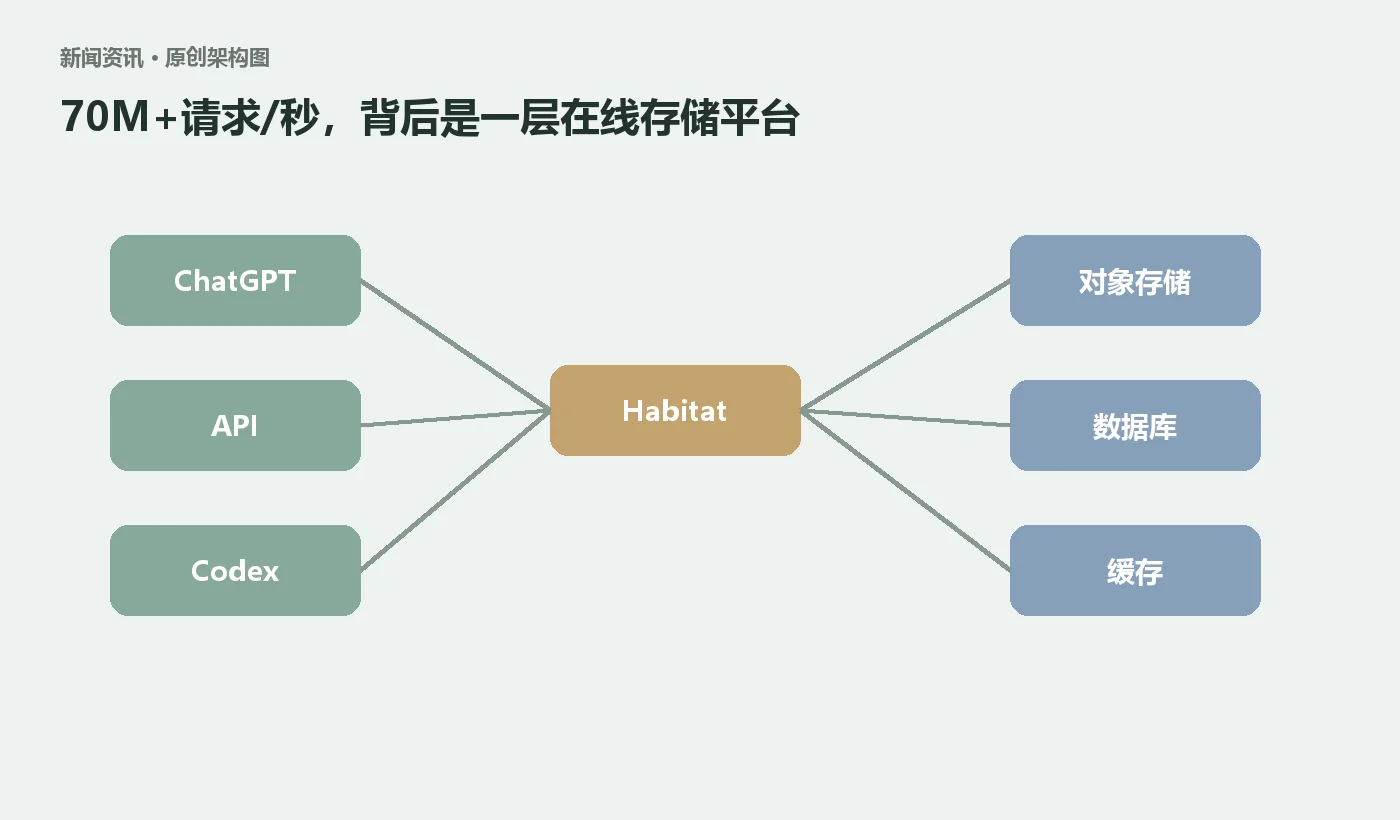
Habitat到底负责什么
按照OpenAI工程文章,Habitat位于ChatGPT、API、Codex等客户端与底层存储资源之间。它统一处理缓存、访问控制、数据驻留、加密、多租户隔离、限流和路由,再把请求交给Azure Cosmos DB、Nanobase、Valkey、Blob存储等资源。
简单理解,Habitat像一层交通枢纽。上面的产品不必各自重复实现所有数据库细节,下面的存储也能通过统一规则被访问。
| 指标 | 官方披露 | 我看到的含义 |
|---|---|---|
| 用户规模 | 每周10亿以上 | 流量来源多且波动大 |
| 请求量 | 每秒7000万以上 | 尾延迟和连接管理很关键 |
| 数据量 | 500PB以上 | 路由、驻留和成本都变复杂 |
| 地理范围 | 接近40个区域 | 数据位置和全球延迟要同时处理 |
从Python库到平台服务
Habitat两年前还是一个连接单一数据库的Python客户端库。随着产品数量和复杂度增长,团队把它变成独立服务。这样可以集中处理连接池、流量整形和隔离策略,也能减少各业务团队重复造轮子。
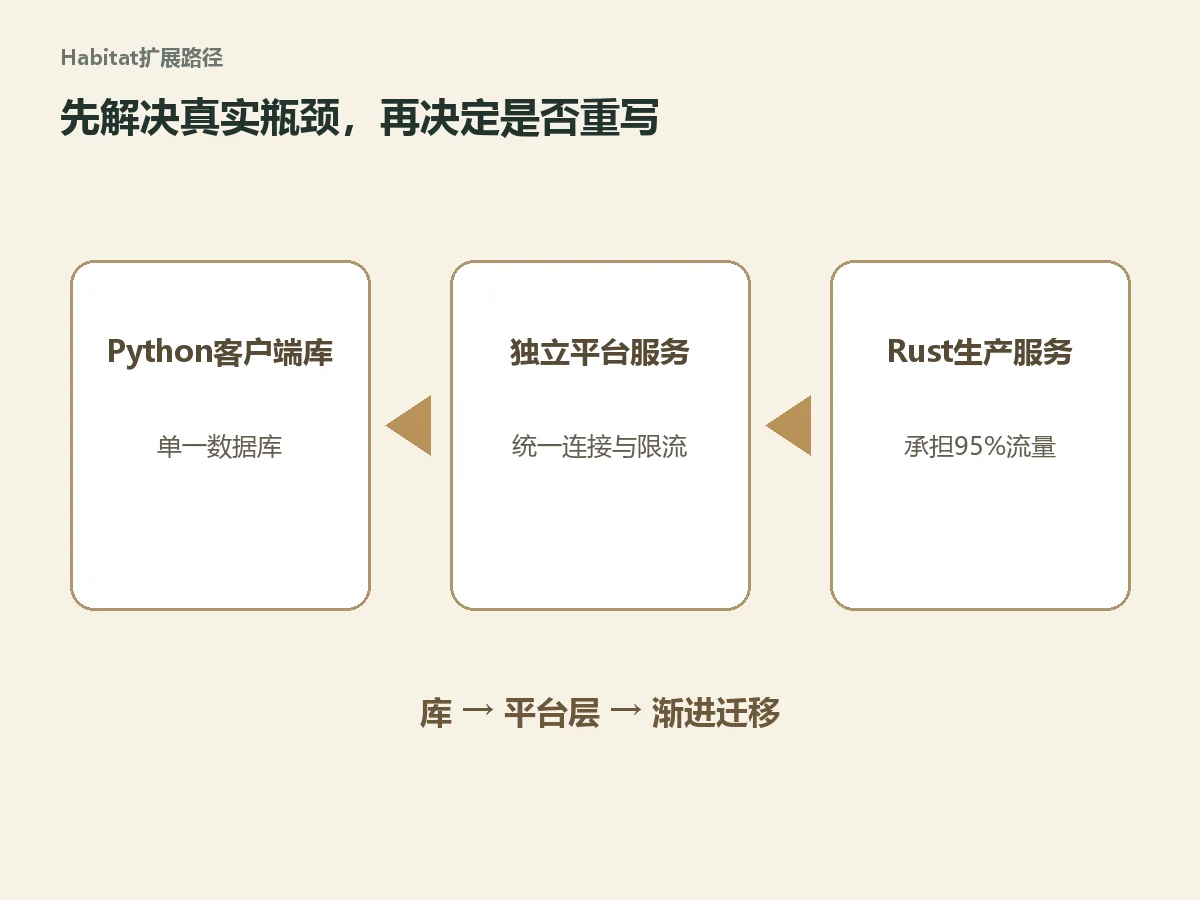
文章提到几个很典型的扩展问题:asyncio调度延迟、功能开关带来的尾延迟、连接池负载不均,以及突发请求把下游资源压垮。我的感受是,大规模系统很少靠一个“神奇架构”解决,更多是在最紧迫的瓶颈上连续做取舍,给下一阶段争取时间。
为什么后来迁移到Rust
OpenAI没有在第一天就重写。Python版本在高峰时已经能服务每秒2000多万次请求,团队把重写推迟约一年,先处理更急的扩展问题。等平台成熟、成本压力继续增加后,才在2026年第二季度由两名工程师配合Codex和GPT‑5.5完成Rust重写。
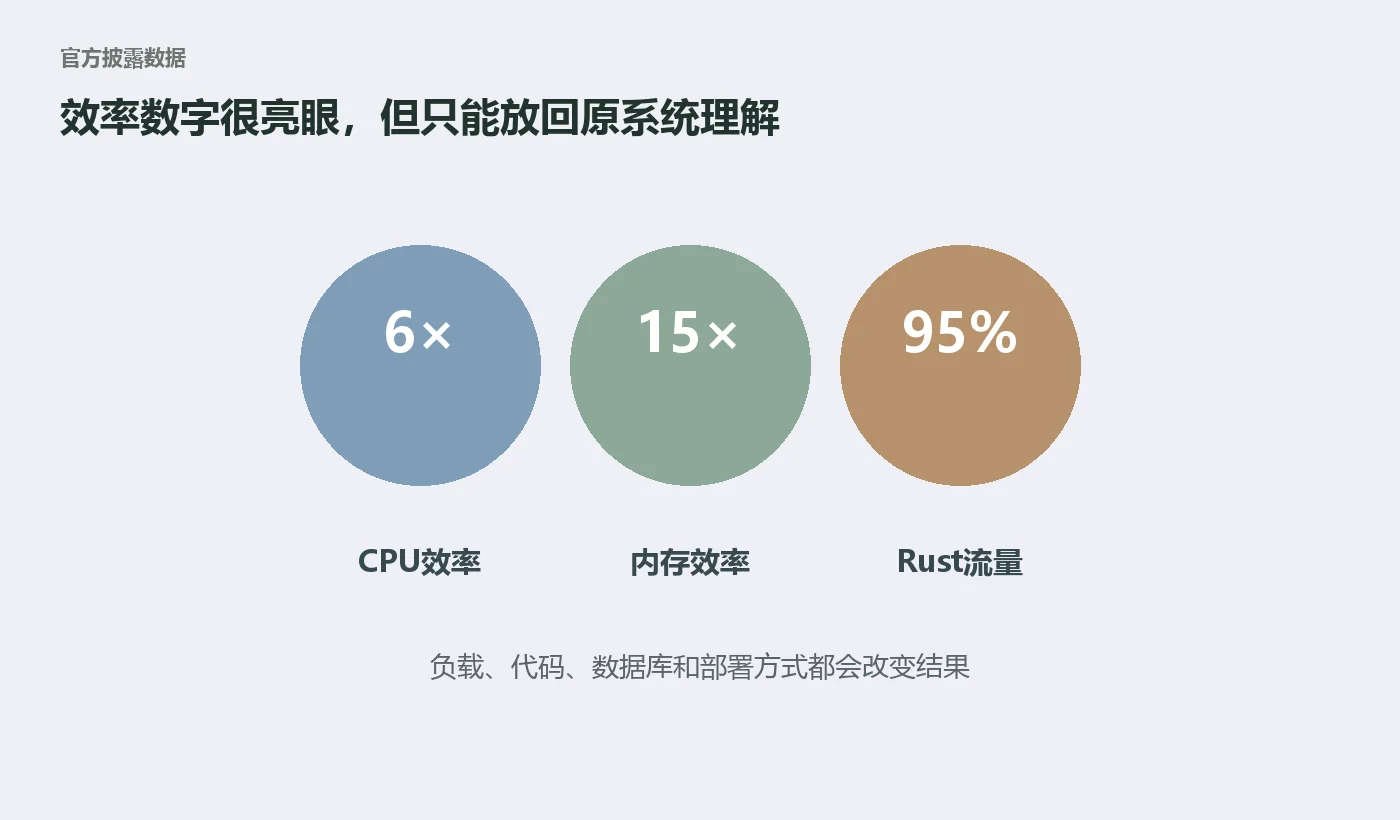
官方称,新Rust服务目前承担95%的生产请求,相比Python版本,CPU效率提高6倍、内存效率提高15倍,平均延迟和尾延迟也更低。这些数字针对OpenAI自己的服务、代码和负载,不能直接套到普通Web项目。
我觉得最值得学的三个工程取舍
第一,先把边界统一,再谈语言。Habitat先从客户端库发展成稳定的平台层,团队已经看清真实流量和瓶颈,重写目标才不会飘。
第二,保留渐进迁移。Rust版本承担95%请求,说明切换经过了流量转移过程。大型系统把全部流量一次切过去,回退成本会很高。
第三,优化“系统总成本”。语言运行效率只是其中一项,连接池、限流、缓存、路由和数据库优化同样决定最终表现。
这篇文章还没回答什么
这是两部分系列的第一篇。OpenAI表示后续会继续解释多租户可靠性、分层读优化和Azure Cosmos DB扩展。本篇没有公开全部SLA、故障率、费用、数据一致性策略或灾难恢复细节。
所以我会把它当作一份可信的官方工程案例,不会把披露数字写成通用基准。你的小服务如果只有几千QPS,直接重写Rust未必比修好查询、缓存和观测更划算。
常见问题
Habitat是OpenAI新推出的用户产品吗?
它是OpenAI内部的在线存储平台,文章没有宣布面向外部客户单独销售。
OpenAI已经完全停用Python版本了吗?
文章称Rust服务承担95%的生产请求,并计划在未来几周停用Python版本;发布当日还没有完全结束迁移。
6倍CPU效率能复制到其他项目吗?
不能直接外推。收益取决于代码、框架、负载、数据库和部署方式,应在自己的系统里测量。