语音助手最容易露馅的时刻,常常出现在抢话、听不懂犹豫、背景里有人说话就乱接,或者用户改口后还沿着旧问题继续回答。
OpenAI在2026年9月10日发布GPT‑Live‑1 API,主打自然的全双工对话。模型能同时听和说,并把复杂推理或工具动作交给后端模型。下面是基于官方文档的产品评估,我没有把官方演示写成自己的完整实测。
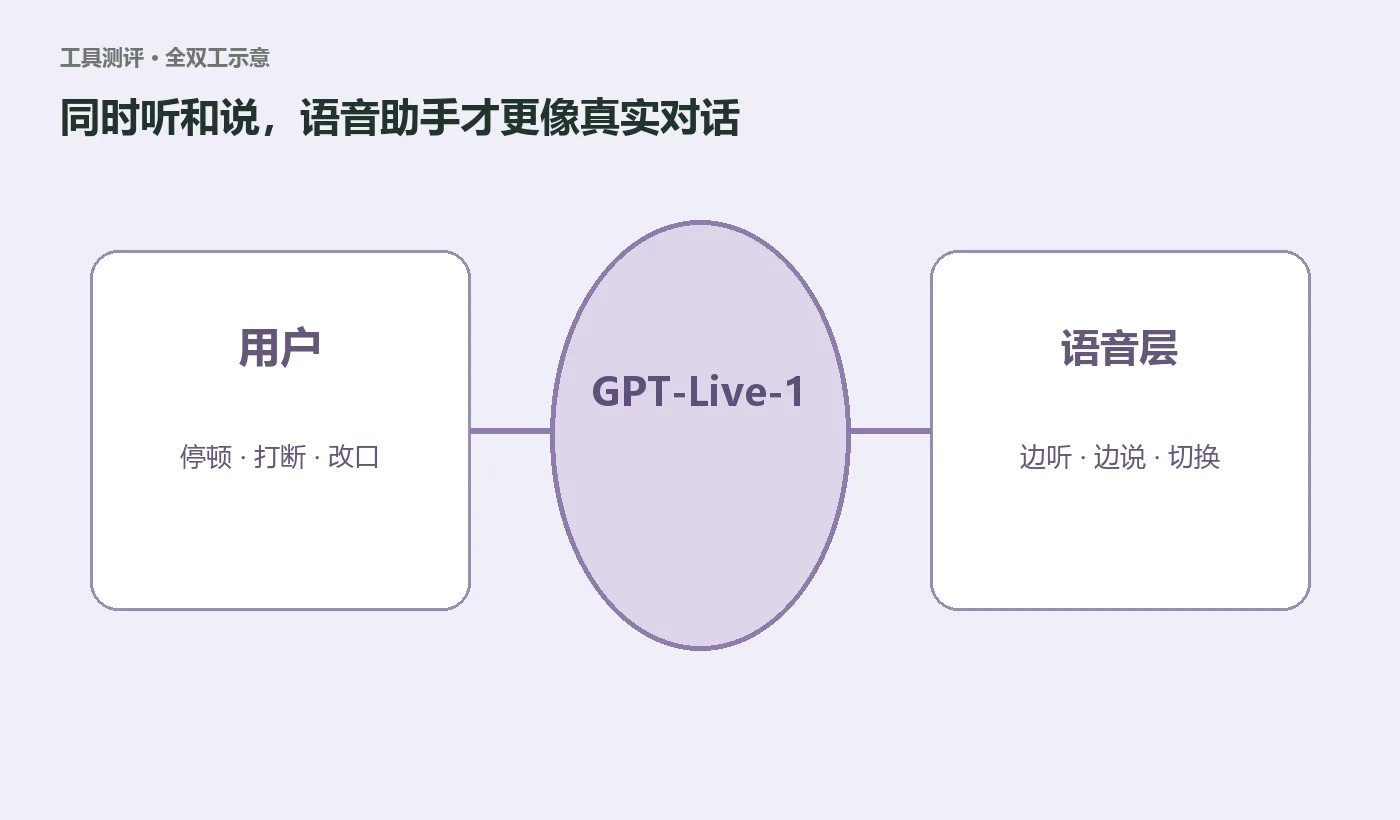
全双工带来的变化
传统语音系统常把语音转文字、文本模型、文字转语音串起来。每一段都可能增加等待,也容易在交接时丢掉打断、停顿和语气。GPT‑Live‑1把听和说放在同一个实时语音层里,重点改善轮次管理。
根据OpenAI发布文章,它的主要能力包括:
- 在用户打断时更自然地停下并切换方向;
- 处理沉默、背景噪声和简短附和;
- 通过系统提示控制语气、语速和表达风格;
- 把深度推理和工具调用交给GPT‑6 Astra等后端模型;
- 在较长会话中保留上下文;
- 支持电话场景。
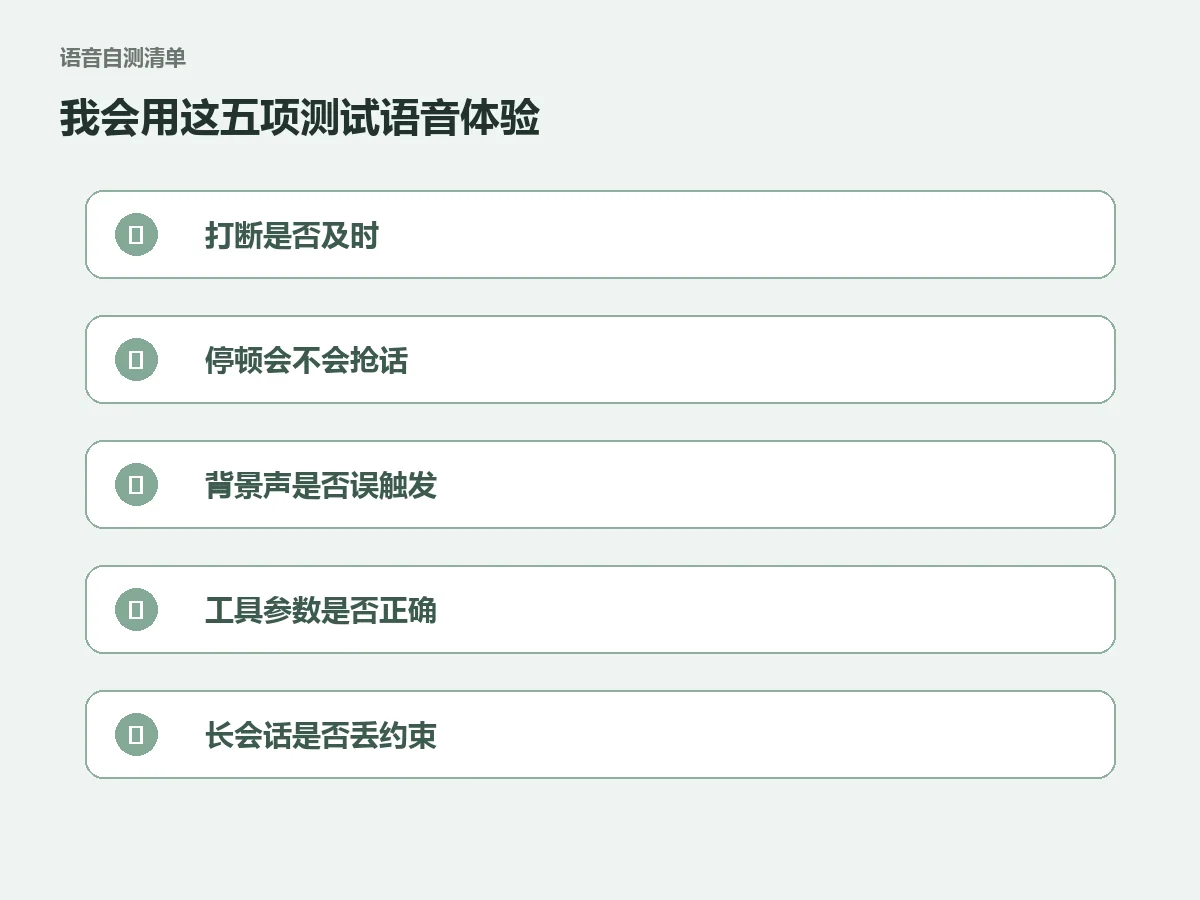
我会重点测的五件事
| 测试项 | 具体场景 | 合格标准要自己定义 |
|---|---|---|
| 打断 | 用户说到一半改需求 | 及时停下,不继续旧答案 |
| 停顿 | 用户思考3到5秒 | 不抢话,也不误判结束 |
| 背景声 | 咖啡店、车流、旁人说话 | 区分主说话人与环境声 |
| 工具调用 | 查订单、改预约前给预览 | 参数正确,高影响动作要确认 |
| 长会话 | 连续沟通20分钟以上 | 不丢关键约束和身份信息 |
官方披露,语言学习产品Speak在早期评估中,相比此前的轮次式系统,打断减少接近80%。OpenAI自己的Full Duplex Bench中,GPT‑Live‑1比GPT‑Realtime‑2.1高30个百分点。这些数据说明了方向,但测试集、语言、设备和网络都会影响你的实际结果。
架构变简单,不代表后端可以省掉
GPT‑Live‑1负责实时语音层,复杂任务仍可交给后端模型和工具。例如,简单排号可以配更快、更便宜的文本模型;涉及退款原因、复杂政策或多系统查询时,再交给推理更强的模型。
我会把语音层和业务层分开:语音层负责听、说、打断和澄清;业务层负责权限、数据读取、工具执行和记录。这样更容易测试,也方便把敏感动作放到明确审批点。
费用要按整条链计算
OpenAI发布时给出的GPT‑Live‑1前端语音层价格是每分钟0.05美元。后端模型、工具、电话线路、日志存储和监控仍可能单独计费。一个客服会话如果平均10分钟,语音层就是0.50美元,最终成本还要加上其余组件。
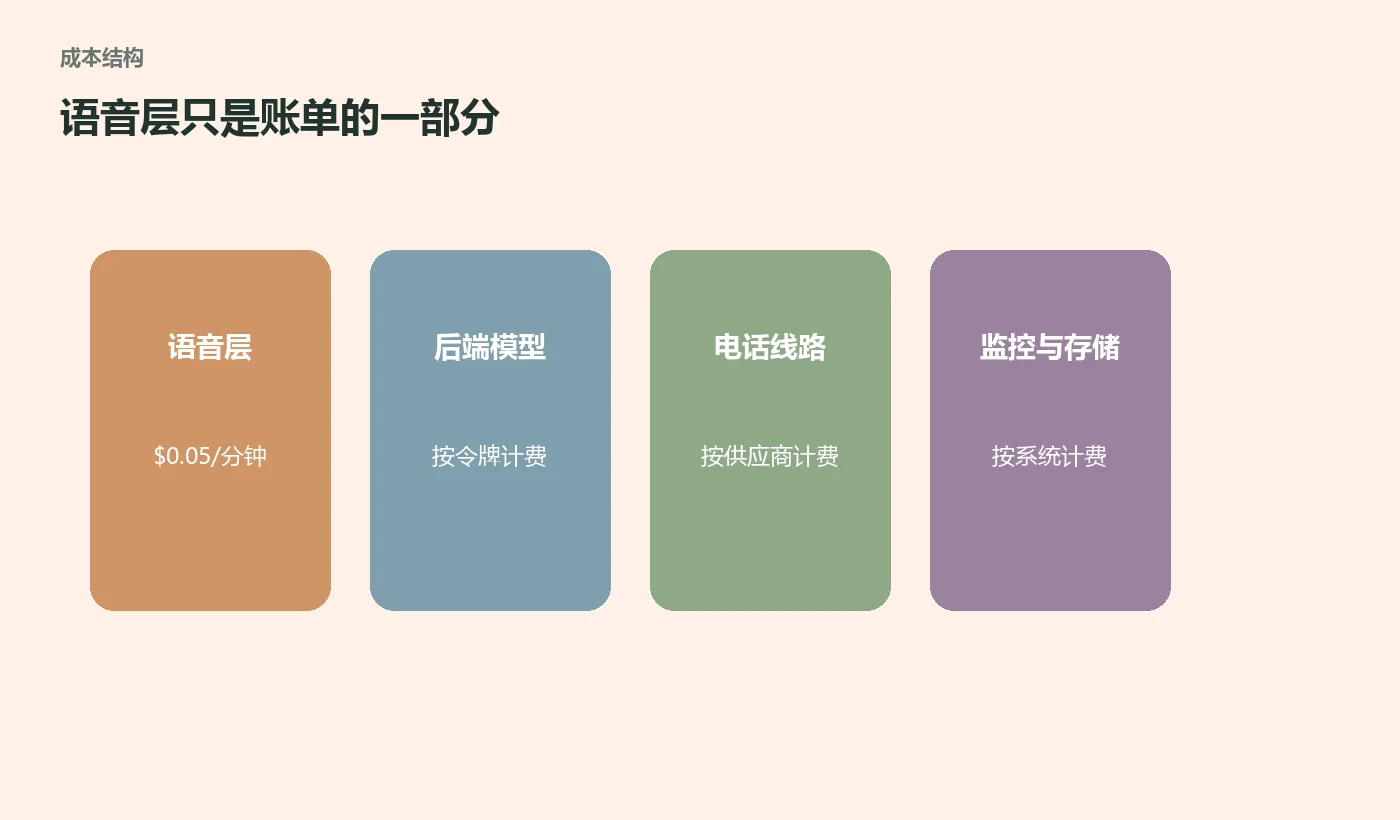
所以我不会只看“每分钟多少钱”,会同时记录:平均通话时长、一次解决率、转人工率、工具调用次数、失败重试和静默等待。语音更自然却让通话拖得更长,也可能把费用抬高。
哪些场景适合先试
预约确认、订单查询、语言练习、基础客服分流和现场语音助手都比较适合。首批场景最好有清楚脚本、有限工具和随时转人工的出口。
医疗、金融和高价值交易要更谨慎。官方案例里出现医疗语音公司的评价,不等于模型可以独立给诊断或做高风险决定。你的权限、合规、留痕和人工审核仍要单独设计。
我的上线建议
先做一个小规模影子测试:让系统听真实但已脱敏的对话,只给建议,不对外说话。通过后再开放内部员工使用,最后才接真实客户。每一步都保留录音或转写抽检、失败标签和回退按钮。
常见问题
GPT‑Live‑1能完全替代客服人员吗?
官方介绍的是语音模型能力。复杂投诉、敏感决定和异常情况仍需要清楚的转人工机制。
它只能搭配GPT‑6 Astra吗?
文章称可以把推理和工具调用交给Astra或第三方模型,开发者可以按任务选择后端。
每分钟0.05美元包含全部费用吗?
这是发布时公布的前端语音层价格。后端模型、工具和电话等费用需要另算,并以最新价格页为准。