“直接问一句,AI就把公司数据做成仪表盘”,听起来很省事。但我看这类工具时,第一反应会落到三个更实际的问题:它接得上哪些数据?用的是不是公司的指标口径?会不会绕过原有权限?
OpenAI在2026年9月10日发布Data agent,入口在ChatGPT Work的插件目录中。它可以连接获批的数据源,调查指标变化,并生成可继续追问和分享的交互式仪表盘。这篇是基于官方资料的功能评估,我没有把它写成亲手跑过全部连接器的实测。
它真正想缩短的是分析链条
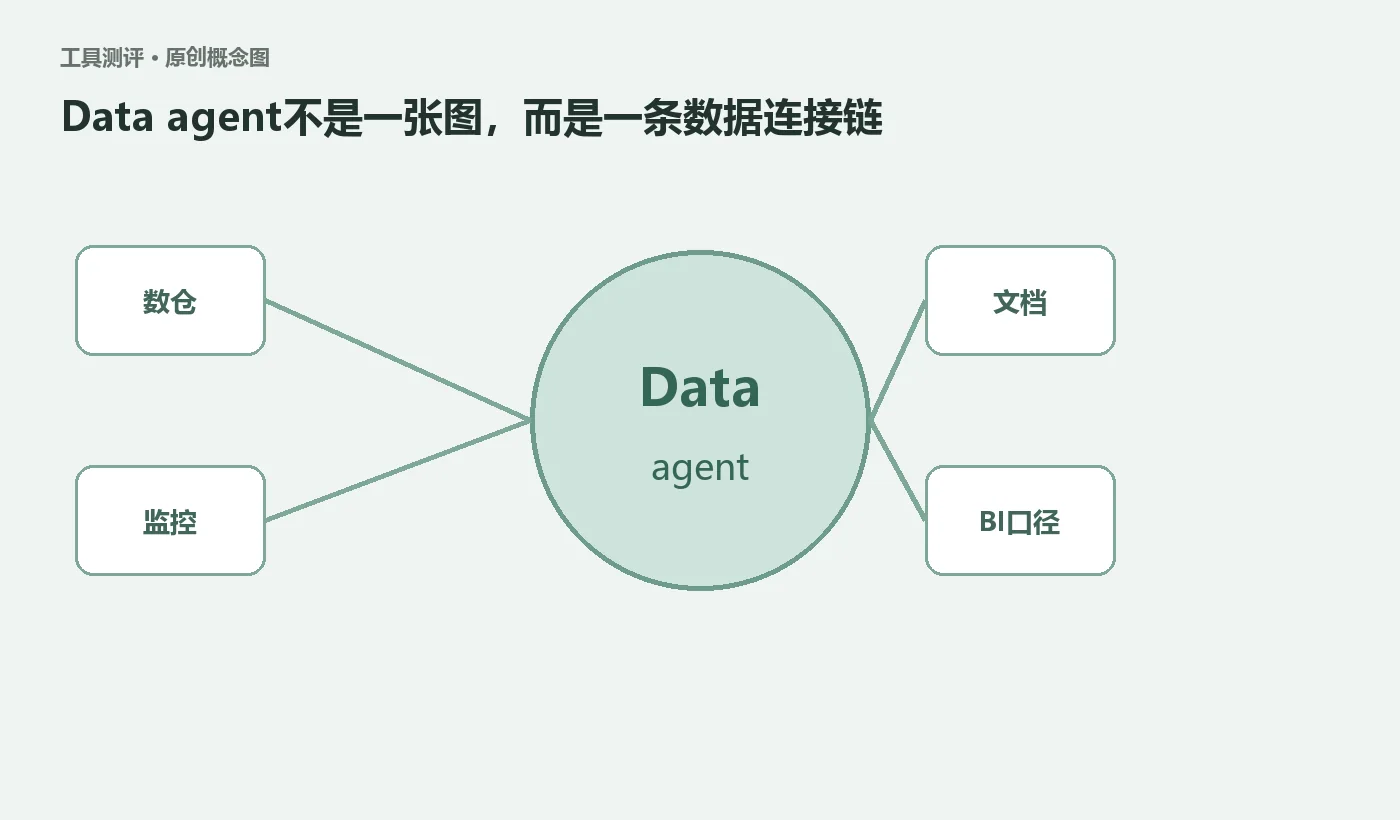
很多业务问题卡在中间环节:运营发现销售下降,要先找数据团队;数据团队再确认表、口径和筛选条件;报告出来后,业务又会追问地区、渠道和时间段。Data agent想缩短的是这条往返链路。
根据OpenAI产品公告,它目前可连接的来源包括Amazon Redshift、Datadog、Google BigQuery、ClickHouse、Databricks、MongoDB、Snowflake等,也能把Google Drive和SharePoint中的文件与文档带入分析。具体能否使用,取决于工作区管理员、插件可用性和第三方连接配置。
我认为最关键的三项能力
| 能力 | 官方描述 | 使用前要确认 |
|---|---|---|
| 连接数据 | 从获批的数据源和文件读取信息 | 表、行、列权限是否沿用 |
| 理解业务口径 | 使用语义层、指标定义和可信仪表盘 | “收入”“活跃”等定义是否唯一 |
| 连续分析 | 在对话中追问、比较并生成仪表盘 | 筛选条件和时间范围是否可见 |
其中第二项最容易被忽略。同一个“客户数”,有人按注册算,有人按付费算;同一个“本月”,也可能按自然月或财务月。模型表达再流畅,口径错了,结果仍然会误导决策。
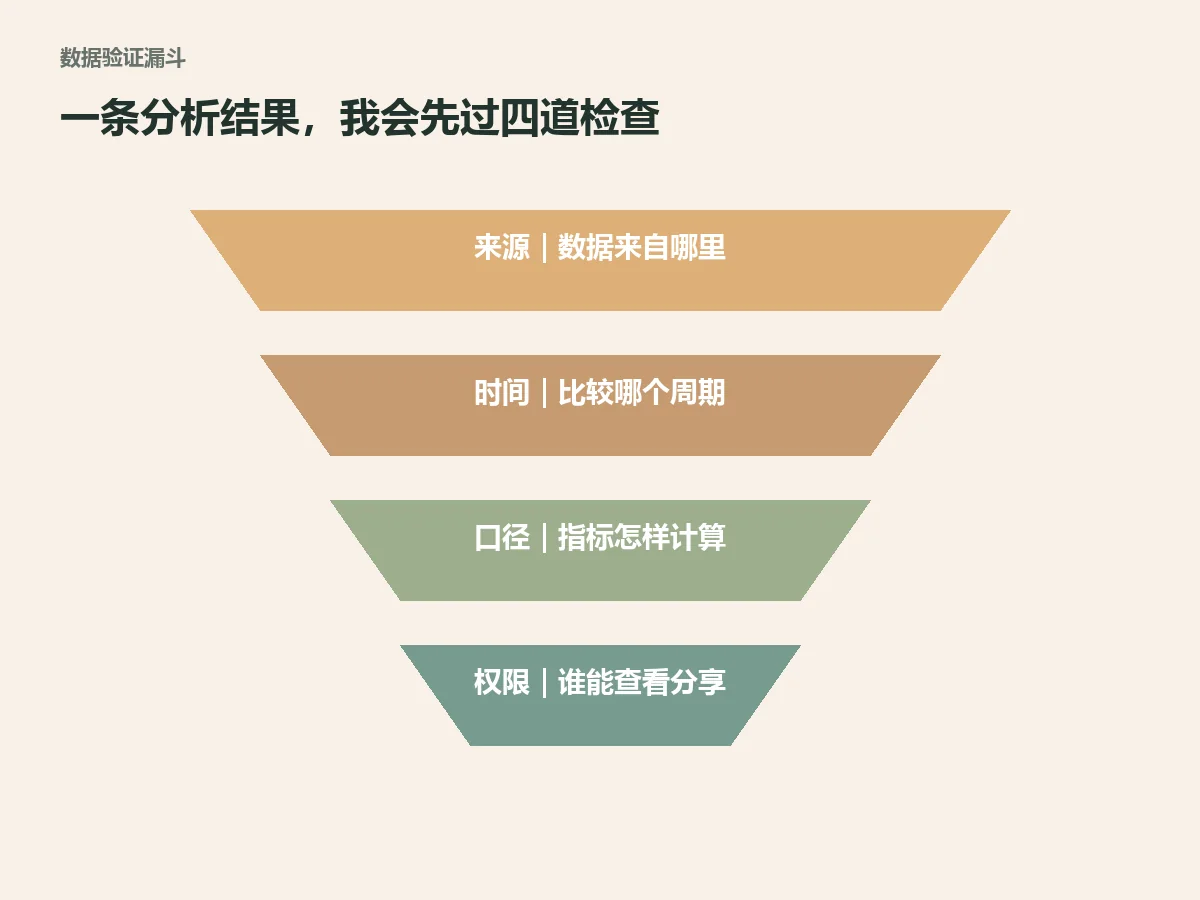
权限边界要在安装前看清
官方说明管理员可以在工作区设置中安装Data插件、配置相关数据源,并控制哪些人能用。现有数据访问控制仍然是基础。我的建议是,先用一个低风险、口径清楚的数据集试跑,不要第一天就把所有数据仓库和文档源都接进去。
我会检查下面五项:
- 普通成员是否只能看到自己原本有权访问的数据;
- 结果页面能否显示来源、表名、时间范围和筛选条件;
- 仪表盘分享给别人后,权限怎样重新判断;
- 涉及邮件或外部动作时,是否需要明确批准;
- 管理员能否审计连接、调用和分享记录。
工具能“行动”时,权限检查比回答质量更重要。尤其是把分析结果发送到Slack或邮件这类动作,最好先看预览,再由人确认。
哪些任务适合先试
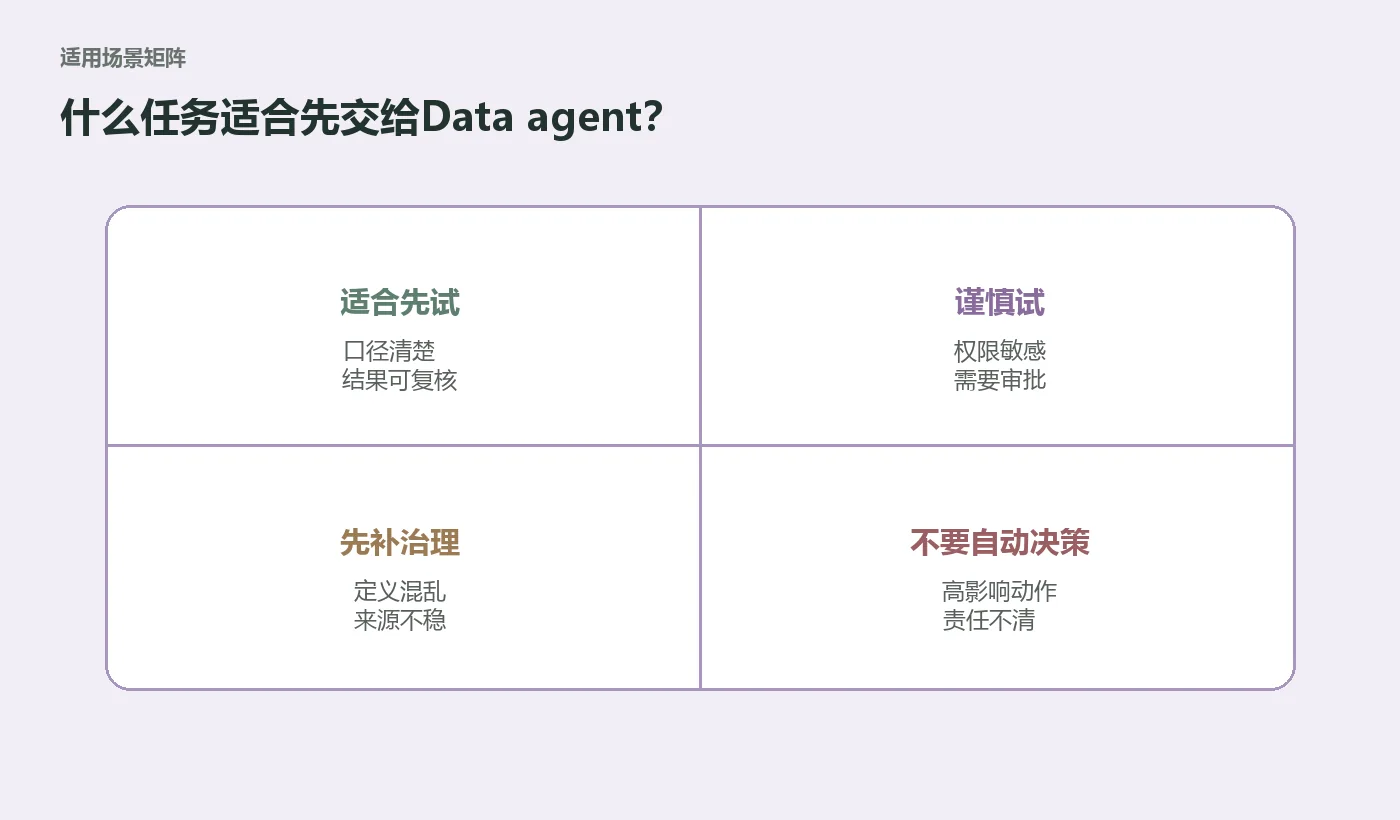
我会从“已有可信数据、问题清楚、结果能复核”的任务开始:
- 比较本周与上周活跃用户,并列出变化最大的渠道;
- 检查某个销售漏斗在哪一步掉得最多;
- 把月度指标整理成领导简报,并标出缺失数据;
- 用公司现有口径设计KPI框架草案;
- 对异常波动给出下一步核查清单。
不适合一上来就交给它的,是口径争议很大、权限高度敏感、或结论会直接触发重大决策的任务。Data agent可以加快调查,不应替业务负责人签字。
一套20分钟的试用清单
先挑一份你已经知道答案的小数据集。连续问五个问题:总量是多少、与上一周期相比怎样、哪个分组变化最大、引用了哪些口径、缺失值怎么处理。再故意问一个越权问题,检查它是否拒绝或看不到数据。
最后记录四个指标:答案能否复算、来源是否清楚、追问是否保持筛选条件、做完一次分析总共省了多少往返。这样比看官方示例更能判断它是否适合你的团队。
我的选择建议
如果公司已经有清楚的语义层、成熟权限和多套数据源,Data agent的价值可能很直接;如果指标定义还散在聊天记录里,先补数据治理更划算。小团队只有几份表格时,普通数据分析功能也许已经够用,不必为了“智能体”三个字增加连接成本。
常见问题
Data agent面向所有ChatGPT个人用户吗?
官方目前把它放在ChatGPT Work的插件体系中,是否可见还受工作区、管理员和地区等条件影响。
使用Data agent需要会写SQL吗?
官方定位是用自然语言提问,不要求用户编写查询;但核对指标定义、来源和权限仍然需要业务与数据知识。
它生成的仪表盘可以直接用于决策吗?
建议先复核来源、时间、筛选条件、指标口径和缺失值处理。高影响决策仍应由负责人审查。