“AI把几年工作缩到几小时”很容易让人兴奋,也最容易被误读。OpenAI最近公开了César de la Fuente实验室寻找新抗菌分子的案例。我读完后觉得,AI在这里帮助研究团队从巨大的基因组和蛋白质数据中,更快筛出值得进入实验室的候选分子,并没有直接发明一种新药。
这一区别很重要。筛选更快,和药物已经安全有效,是完全不同的阶段。
他们怎样把“生命代码”变成搜索空间
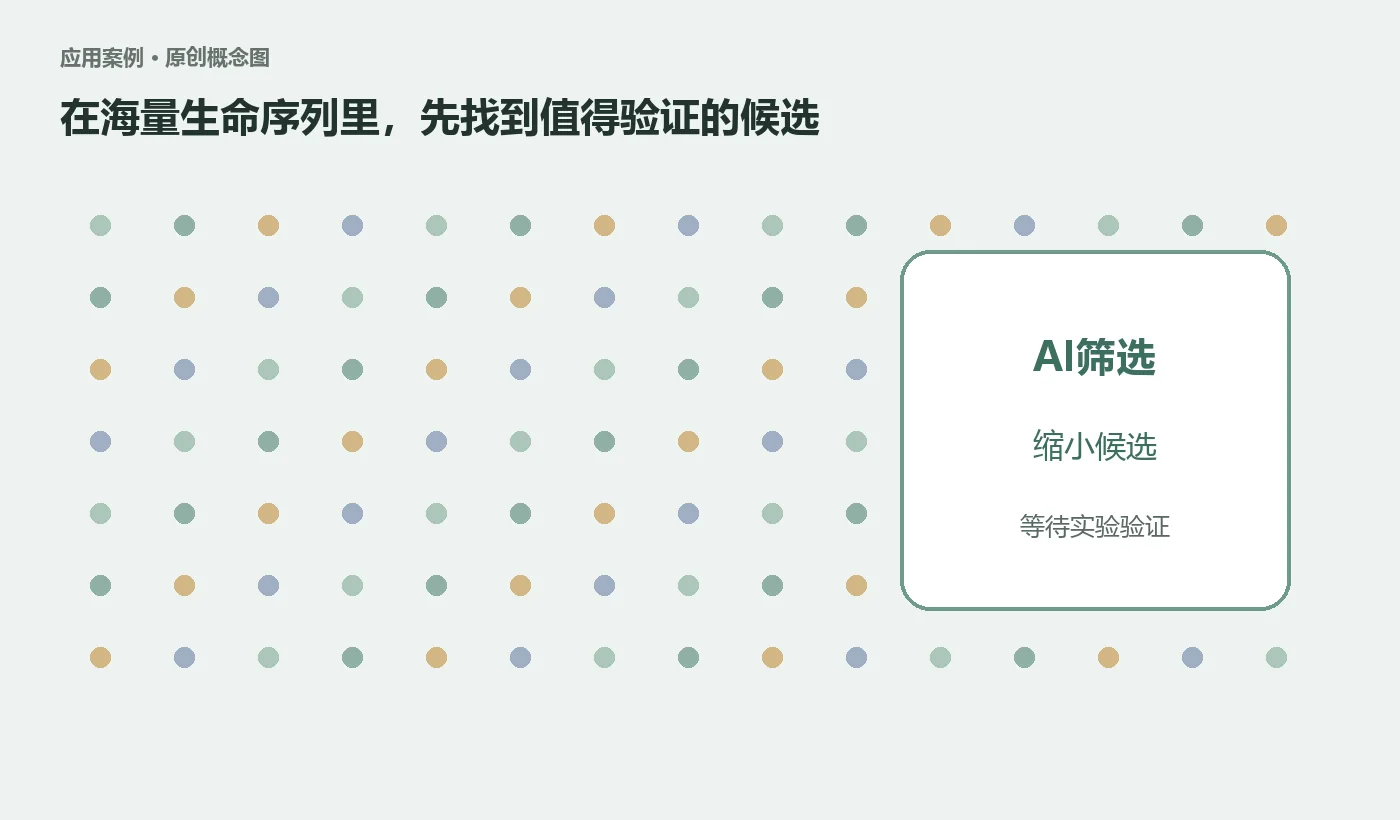
根据OpenAI在2026年9月10日发布的案例,de la Fuente团队会在现存和已灭绝生物的基因组中寻找可能具备抗菌作用的分子。团队把DNA、蛋白质和肽序列当作可分析的信息,让深度学习模型从海量序列里识别模式并排列候选项。
OpenAI文章称,这种方法可以把早期候选搜索从多年缩短到数小时。这里的“早期”不能丢:它指的是从巨大数据空间中找线索,而不是完成毒性、剂量、制造、临床试验和监管审查。
ChatGPT和Codex具体帮了哪些忙
公开案例没有说团队只靠一个聊天窗口完成研究。实验室有自己的AI模型,同时使用ChatGPT和Codex处理下面这些环节:
| 环节 | AI承担的工作 | 人仍要负责的部分 |
|---|---|---|
| 假设形成 | 头脑风暴、连接跨学科概念 | 判断问题是否有科学价值 |
| 编程 | 编写和改进代码 | 审查方法、依赖与结果 |
| 数据准备 | 下载、整理、预处理基因组数据 | 确认来源和质量 |
| 结果分析 | 组织发现、解释术语 | 验证生物学意义 |
| 团队协作 | 帮不同专业成员理解彼此 | 研究设计与最终决策 |
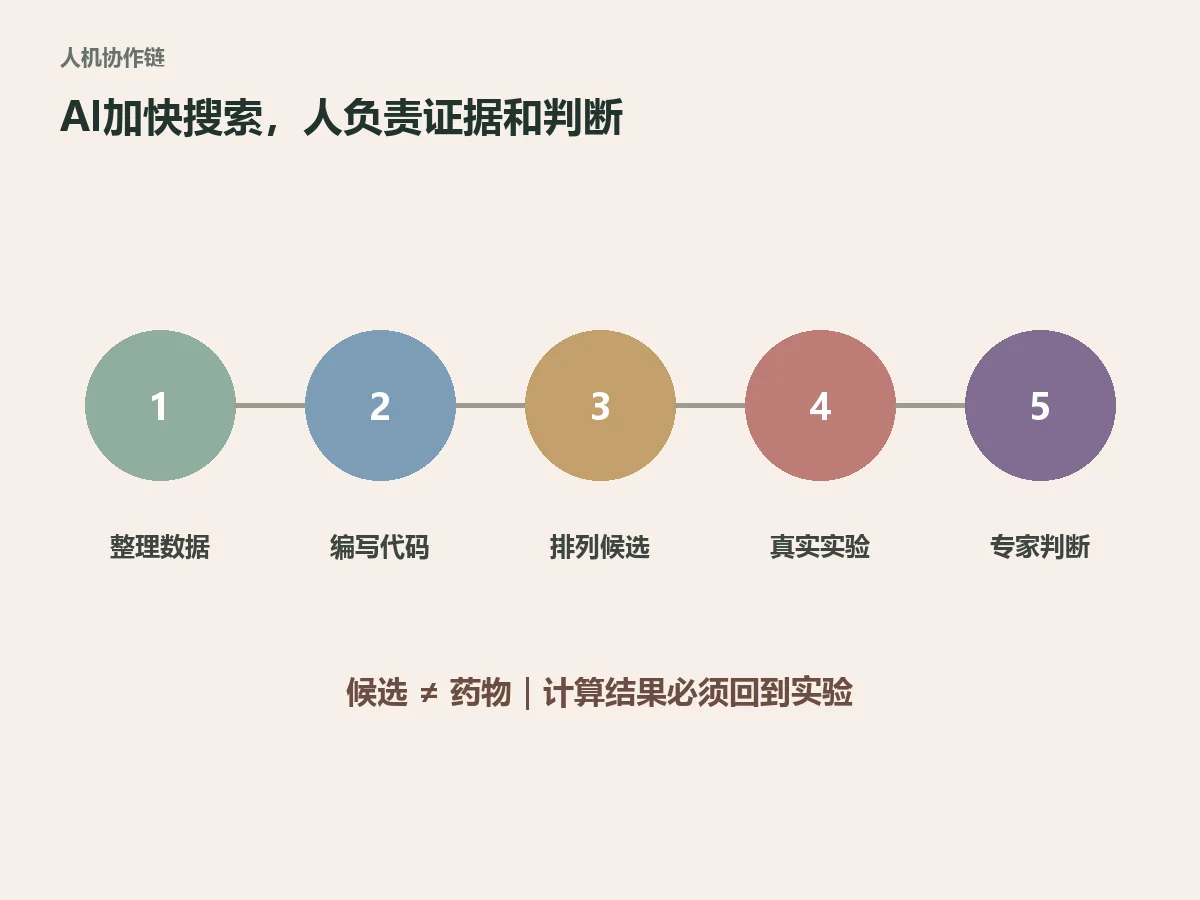
我觉得这个案例最有意思的地方,是AI在“跨学科翻译”上发挥作用。生物学家不一定擅长写程序,程序员也未必熟悉化学和微生物学。模型能帮助他们快速补齐术语和代码草案,减少每次协作的启动成本。
为什么实验验证一步都不能少
一个候选分子看起来有希望,研究才刚开始。科学家还要确认它能否杀死目标微生物、有效剂量是多少、对人体细胞有什么影响。后续还包括毒性、耐药性、体内行为、稳定性、制造方式、监管与临床试验。
世界卫生组织在2026年7月更新的抗微生物药物耐药性事实页中指出,2021年全球超过470万例死亡与细菌耐药性相关,2023年全球实验室确认的细菌感染中约六分之一对抗生素耐药。问题确实紧迫,但紧迫更要求证据扎实。
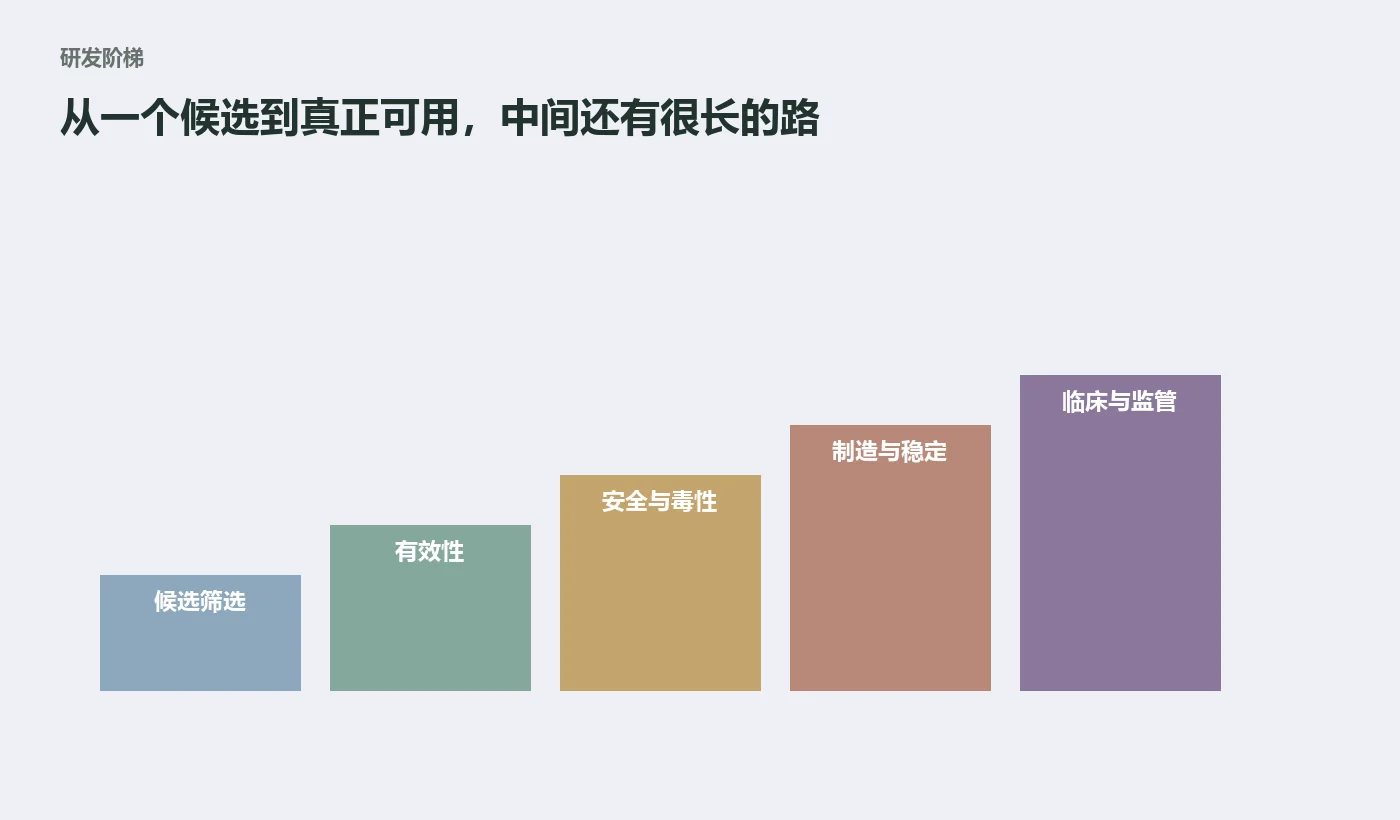
公开案例也直接强调“真实实验”对验证AI预测不可替代。模型可以给候选排序,却不能凭文字输出证明分子对人体安全。
普通研究和产品团队能借鉴什么
我会把这套流程总结成“扩大搜索、缩小候选、现实验证”三步:
- 让AI处理人力难以逐项浏览的大规模资料;
- 用明确指标把候选缩到可管理范围;
- 把最终判断交给实验、用户测试或真实业务数据。
这也适用于内容选题、客户研究和软件测试。AI可以先扫描大量反馈,找出高频问题;团队再抽样核对原文,并用真实实验确认优先级。关键是不要把“模型认为值得看”写成“已经证明有效”。
这个案例的限制
这是OpenAI对合作研究团队工作方式的案例介绍,不是随机对照研究,也没有给出一套所有实验室都能复制的统一成功率。文中的速度描述针对候选发现的早期阶段,不应直接外推到完整药物研发周期。
另外,生物数据、代码和模型输出都可能有偏差。数据来源、样本代表性、计算方法和实验条件仍需专业团队记录与复核。
常见问题
AI已经发现可以使用的新抗生素了吗?
这篇公开材料讲的是候选分子搜索和研究流程,不能据此认定某个候选已经通过临床与监管审批。
为什么说从几年缩短到几小时?
官方描述针对早期候选搜索。完整研发还包括实验验证、安全性、制造、临床试验和监管等长期环节。
小团队可以照搬这套方法吗?
可以借鉴“AI筛选、人验证”的结构,但具体数据、风险控制和验证标准必须由相应领域专家设计。