看到“AI运行量子实验”这几个字,我第一反应也很容易跑偏:是不是模型已经能自己当科学家了?但把OpenAI公开的MIT案例读完,答案其实更务实。AI接手的是一套软件可控、步骤明确、结果能连续反馈的常规测量;信号一旦变弱、变吵或出现反常现象,经验丰富的研究员仍然要介入。
这反而是个很有参考价值的案例,因为它没有把AI包装成万能大脑,而是展示了怎样把一个复杂流程切成模型可以执行、检查和继续的步骤。
他们具体做了什么
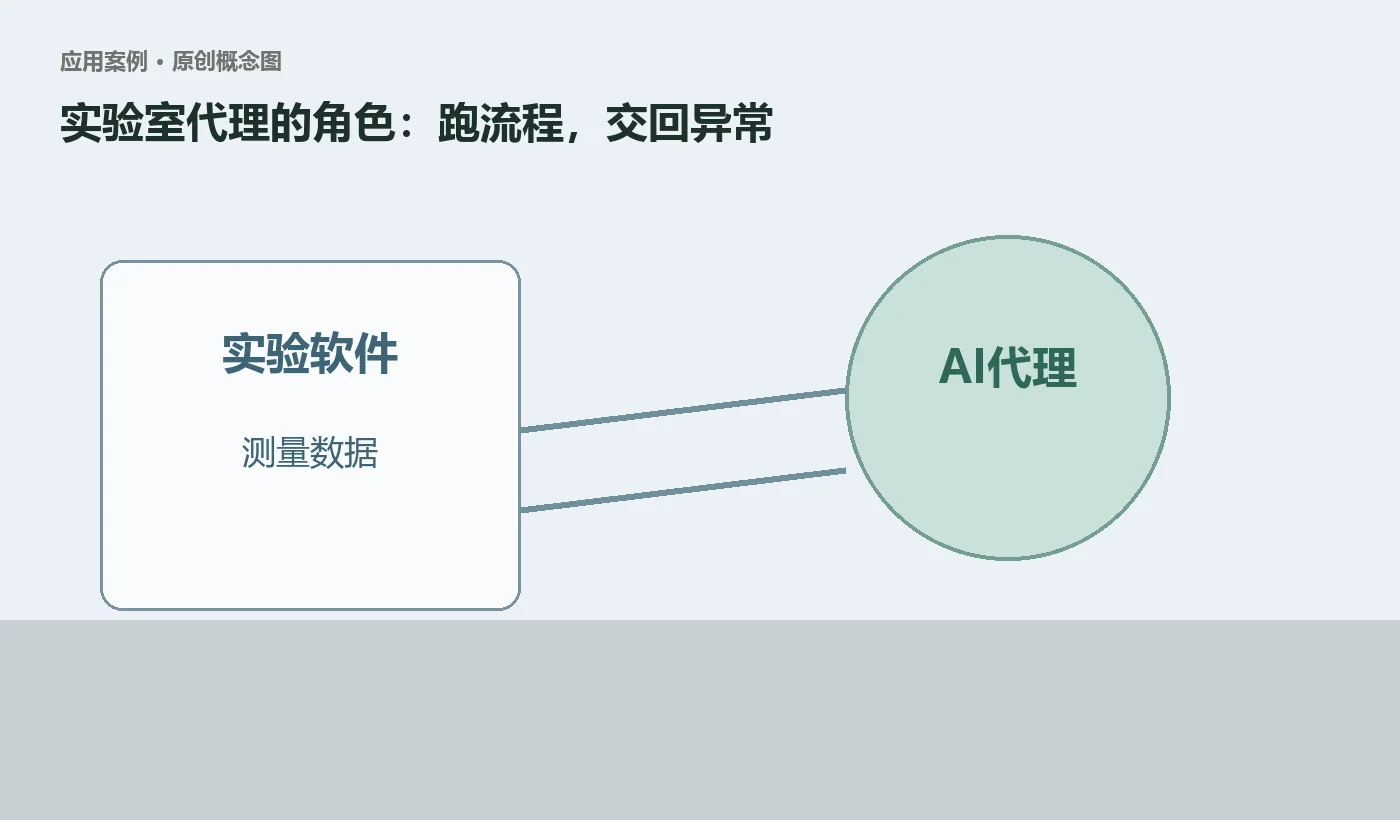
根据OpenAI在2026年9月8日发布的案例,MIT Engineering Quantum Systems Group的研究生Beatriz Yankelevich,把由GPT-5.6 Sol驱动的Codex连接到实验室软件。这个软件负责协调超导量子比特的测量。
超导量子芯片制造、封装并冷却后,研究人员主要通过软件与它交互。校准过程需要一系列彼此依赖的测量:前一步的结果会决定下一步用什么参数。OpenAI称,一块芯片的准备可能需要数百到数千次前期测量,整个过程可能持续数月。
团队给代理提供了针对不同测量的技能说明和芯片设计目标。代理随后选择参数、操作硬件、分析返回数据,再决定调整测量还是保存结果供下一步使用。
为什么这个任务适合AI代理
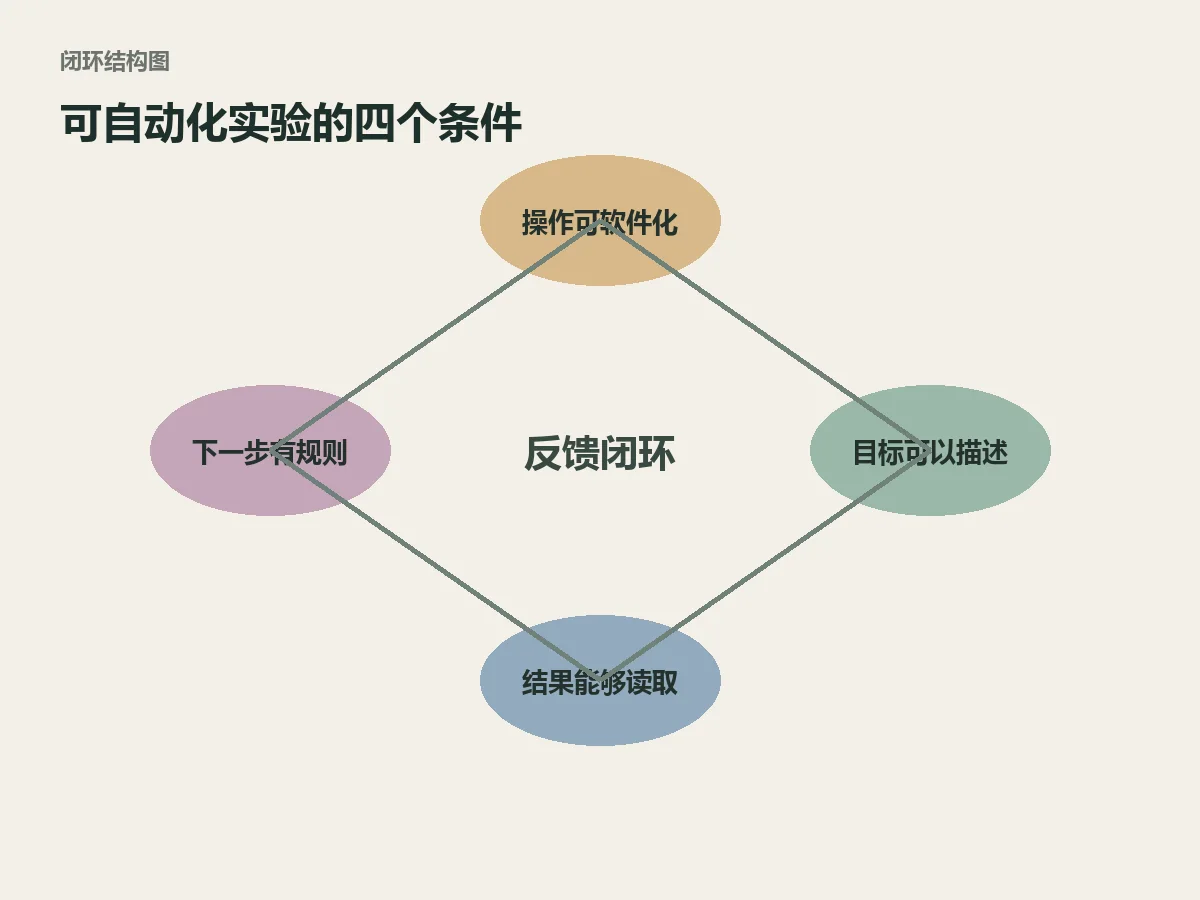
我把原因归纳成四个条件:
| 条件 | 在案例中的对应做法 |
|---|---|
| 操作可软件化 | 芯片冷却后通过实验软件控制 |
| 目标可描述 | 有设计指标和具体测量任务 |
| 结果可读取 | 每轮测量都会返回数据 |
| 下一步有规则 | 根据信号质量调整或保存结果 |
这四点很像自动化测试:给代理工具、边界和反馈,让它沿着明确流程工作。任务越清楚,代理越容易持续推进。
在信号清晰时,案例中的Codex能以较少人工干预完成标准测量序列,包括识别跃迁频率、校准控制与读取脉冲,以及测定量子比特保留信息的时间。团队还让代理在夜间或研究员进洁净室工作时继续跑常规任务。
它卡在哪里
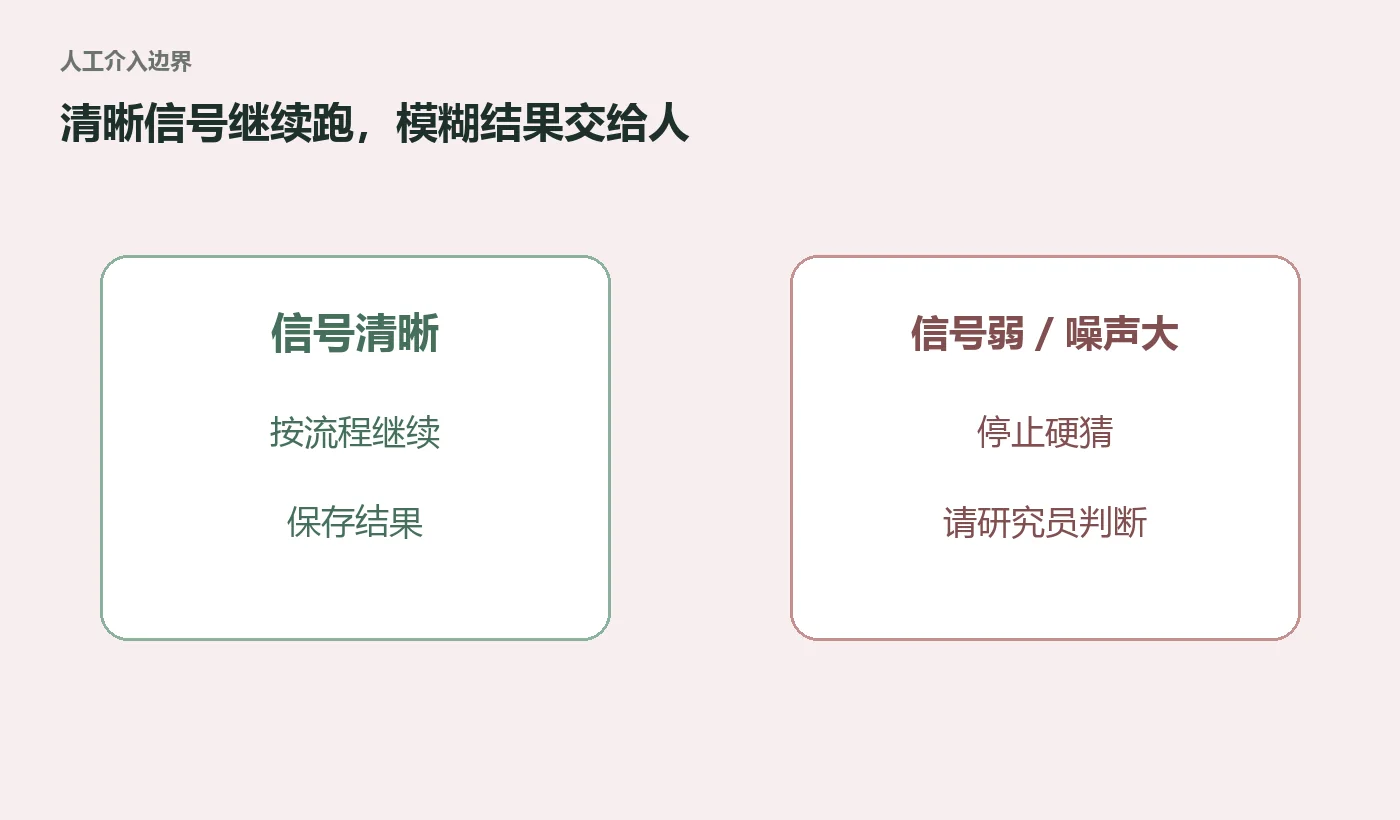
真正关键的是失败部分。OpenAI明确写到,当实验信号较弱或噪声较大时,代理需要更长时间寻找合适参数,有时必须由有经验的研究员指导。研究员可能比当前模型更快识别最佳校准设置。
这说明“自动运行”和“理解未知现象”之间还有距离。常规流程可以交给代理,模糊结果、物理异常和新的研究假设仍需要人的判断。案例来自参与团队与模型提供方的公开材料,也不能直接推广到所有实验室、芯片类型或安全要求。
普通团队最该借鉴的是任务设计
我们当然没有稀释制冷机,但同样的思路能用在内容、数据和运营工作里。一个适合交给代理的任务,最好满足:输入来源固定、操作接口稳定、每一步有可观察结果、失败时能停下来找人。
比如每日报表可以这样设计:代理读取固定数据源,计算指标,遇到缺失值就停止并标记,不自行补数字;通过规则检查后再生成摘要。这样代理负责重复劳动,人负责解释异常。
我会再加三条保险:
- 对硬件、资金、发布或删除操作设置权限边界;
- 保存每一步参数、结果和时间,方便追溯;
- 明确哪些异常必须转给人,避免模型在模糊状态下硬猜。
这个案例真正证明了什么
它证明了代理可以在明确技能、真实软件接口和可读反馈下,长时间执行部分常规实验流程,并给研究员腾出分析和设计时间。它没有证明AI能独立完成科学研究,也没有提供适用于所有实验的通用成功率。
我觉得这份边界感很值得保留。用AI最靠谱的方式,往往是先找“重复、可验证、失败能停”的那一段,而不是一上来把整份工作交出去。
常见问题
AI是在模拟器里运行实验吗?
公开案例说Codex连接到实验室软件并操作真实量子芯片的测量流程,但具体安全架构和全部技术细节应以官方技术案例为准。
研究员还需要盯着吗?
信号清晰时可以较少干预;遇到弱信号、噪声或异常结果时仍需经验判断。研究员也负责实验设计与结果解释。
这个方法能直接搬到其他行业吗?
流程设计思路可以借鉴,具体权限、验证指标和风险控制必须按行业重做,不能照搬实验室配置。