一家工厂想多出货,第一反应可能是添设备、扩仓库。但如果问题出在托盘路线互相挡路,或者某个工位总在等前一道工序,先花钱扩建未必划算。百事与西门子、NVIDIA的数字孪生项目,让我更关心另一种顺序:先在电脑里把改造方案跑通,再决定现场改什么。
这是对公开案例的拆解,没有现场测试或内部经营数据。下文会把企业披露的结果与我的试点建议分开。
1. 百事究竟在虚拟工厂里做什么
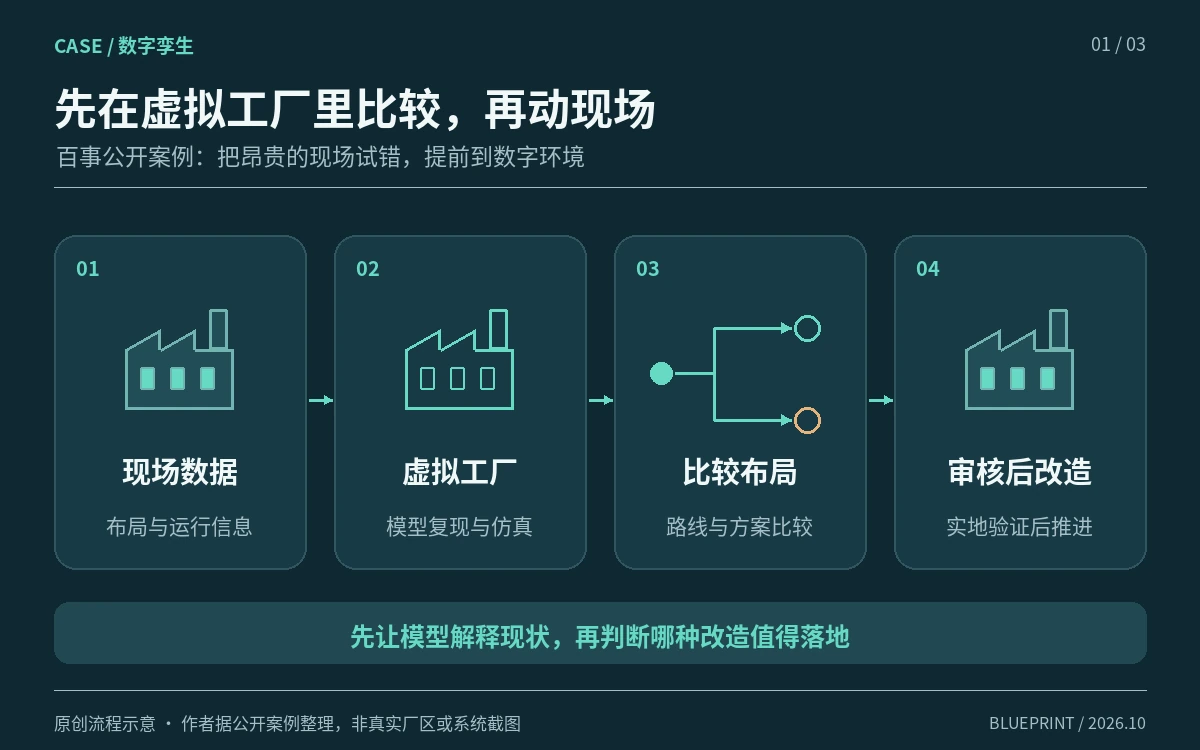
据百事2026年1月的合作公告,项目已在美国部分生产和仓储设施开展早期试点,使用Siemens Digital Twin Composer及NVIDIA Omniverse技术,把布局改动放进数字环境中模拟、验证,再推进实际建设。全球扩展是计划,不能把部分设施的进展写成全集团已经完成。
百事7月的后续说明补充了用途:为现有工厂建立虚拟副本,比较不同布局,尽量不打断日常生产和配送。这让我觉得它的价值很具体:一次现实中的挪机、停线或路线调整,往往比在模型中试一个方案昂贵得多。
2. 漂亮的三维画面,背后还得有运行数据
西门子的产品说明介绍,系统把二维、三维模型与真实运行信息结合,也可连接制造执行、质量管理、设备控制代码和工业物联网等数据源。百事案例里,机器、输送带、托盘路线及人员动线都被纳入模拟,AI代理用于测试、调整系统变化。
我理解的关键是“先重现现状,再比较方案”。假如模型连今天一小时能完成多少件、哪里会排队都解释不清,它算出的新布局优势就很难直接采用。画面逼真能帮助大家讨论,可信的节拍和约束才决定这个讨论有没有用。
3. 20%和10%—15%,要放在不同格子里
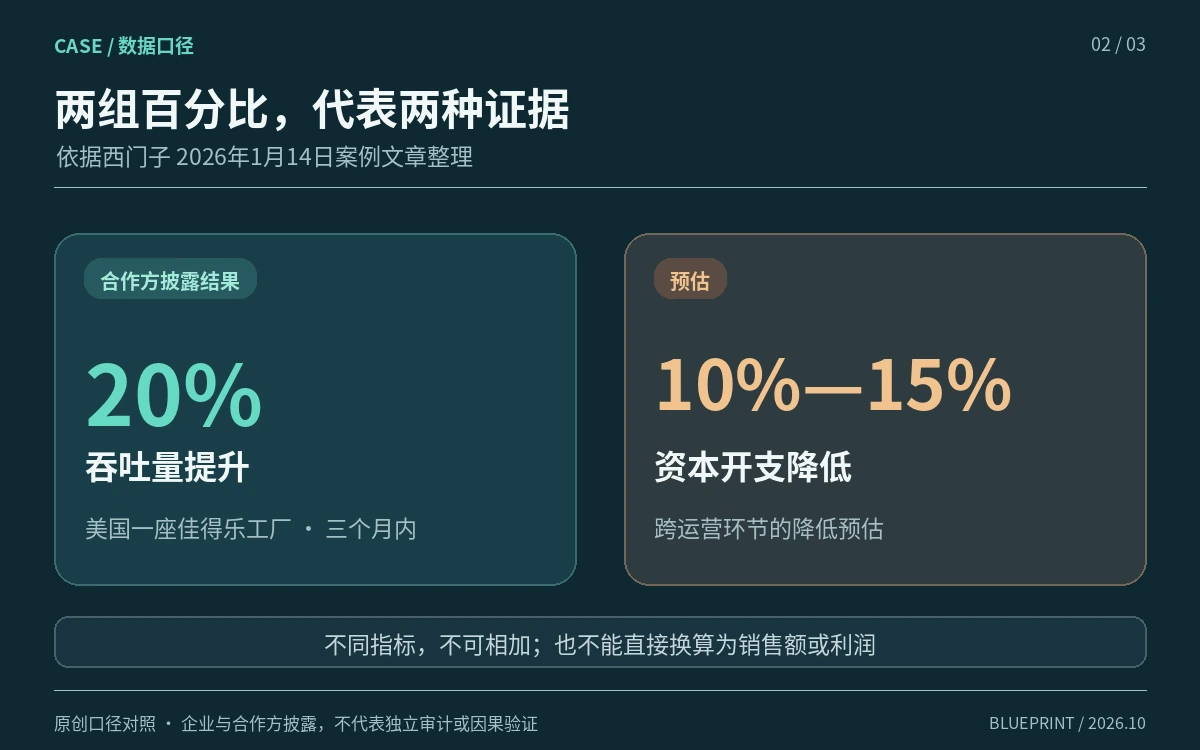
西门子1月14日的案例文章写到,美国一座佳得乐工厂在三个月内实现了20%的吞吐量提升;同文将跨运营环节的资本开支降低10%—15%表述为估算。前者是合作方报告的具体部署结果,后者是预估,不能都写成已经审计完成的全公司收益。
这里的吞吐量也不能直接换算成销售额、利润或员工生产率。文章没有给出足够细的独立对照数据,让外部读者把改善逐项归因于AI、布局调整和其他同期措施。我会保留这些限制,避免用一个好看的百分比替读者做投资判断。
如果拿案例做立项材料,我会在数字旁写明“哪座设施、什么时间范围、对比什么基线、谁发布”。还会追问提高的是某段产线还是最终出货:上游跑得更快,下游暂存区也可能堆得更满。不同工厂的订单结构、班次和设备状态不同,不能直接套用20%作为验收目标。
4. 换成自己的仓库,我会从一处堵点开始
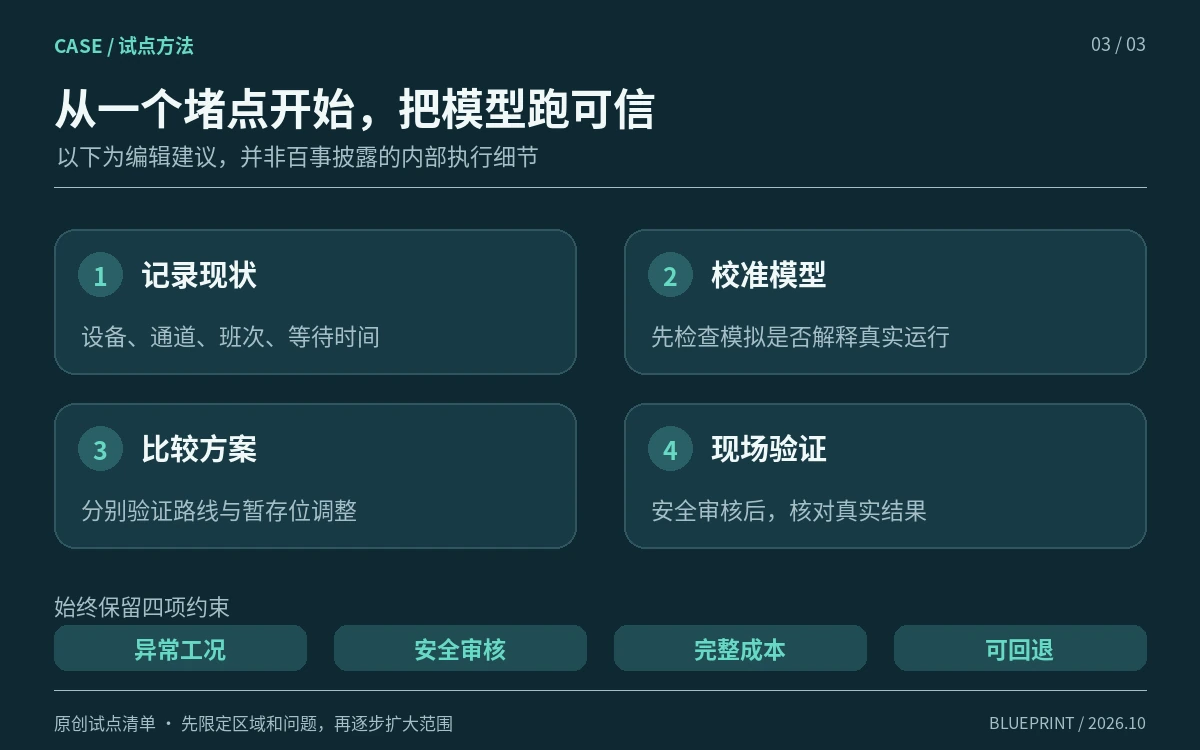
下面是我建议的试点方法,并非百事披露的内部执行细节。先选一个能说清的问题,例如“包装完成的托盘常在出库口等待”,限定一块区域、一类货品和一段可比较的生产窗口,别一开始就追求整厂复制。
- 记录现状:整理设备位置、通道宽度、班次、到货波动和等待时间,给数据标注采集日期及负责人。
- 校准模型:先用已有生产记录检查模型,找出模拟与现场不一致的环节,暂时不急着生成新布局。
- 比较方案:把“调整暂存位”“改变搬运路线”等方案分开跑,同时观察产出、拥堵和人员通行条件。
- 安排实地验证:由工程与安全人员审核,限定可回退的调整范围,再核对真实运行结果。
我会给异常情况也留一页:某条通道封闭、某台设备停机或订单集中到来时,原来胜出的方案还成立吗?这类检查可能让图表没那么漂亮,却更接近实际要面对的一天。
5. 最值得借鉴的是改造顺序
试点结束时,我想看到一份能复核的记录:原布局和新布局、模型版本、用到的数据、实际等待时间,以及软件、集成和维护的完整费用。只有仿真截图,没有现场结果,就还不足以决定全面复制。
百事的案例给我的启发是,把昂贵的现场试错尽量提前到可重复比较的环境里。AI负责扩大能探索的方案范围,企业仍要对输入数据、约束条件和最终改造负责。先用一个可信的小模型解释一个真实堵点,比直接许诺“智能工厂整体提效”更容易做出可靠决定。
资料来源与核对说明
- PepsiCo:与Siemens、NVIDIA的数字孪生合作公告(2026-01-06)
- Siemens:Digital Twin Composer发布说明(2026-01-06)
- Siemens Digital Logistics:百事供应链试点结果与资本开支预估(2026-01-14)
- PepsiCo:数字孪生在现有工厂的应用说明(2026-07-22)
资料核对日期:2026年10月6日。事实依据上文链接的百事及西门子官方页面;效果数字属于企业与合作方披露,试点步骤和评估问题为编辑建议。