看到Gemini 4 Argon公布,我最想确认的是:现在谁能用,正式接入要花多少钱,以及它能否解决手头那类长任务。把这三件事问清楚,才好决定要不要调整现有工作流。
Google在9月30日的官方公告中介绍了Argon,重点放在软件工程、企业知识工作和网络防御。本文按2026年10月6日核对到的公开资料解读;我没有获得模型访问资格,以下不冒充上手实测。
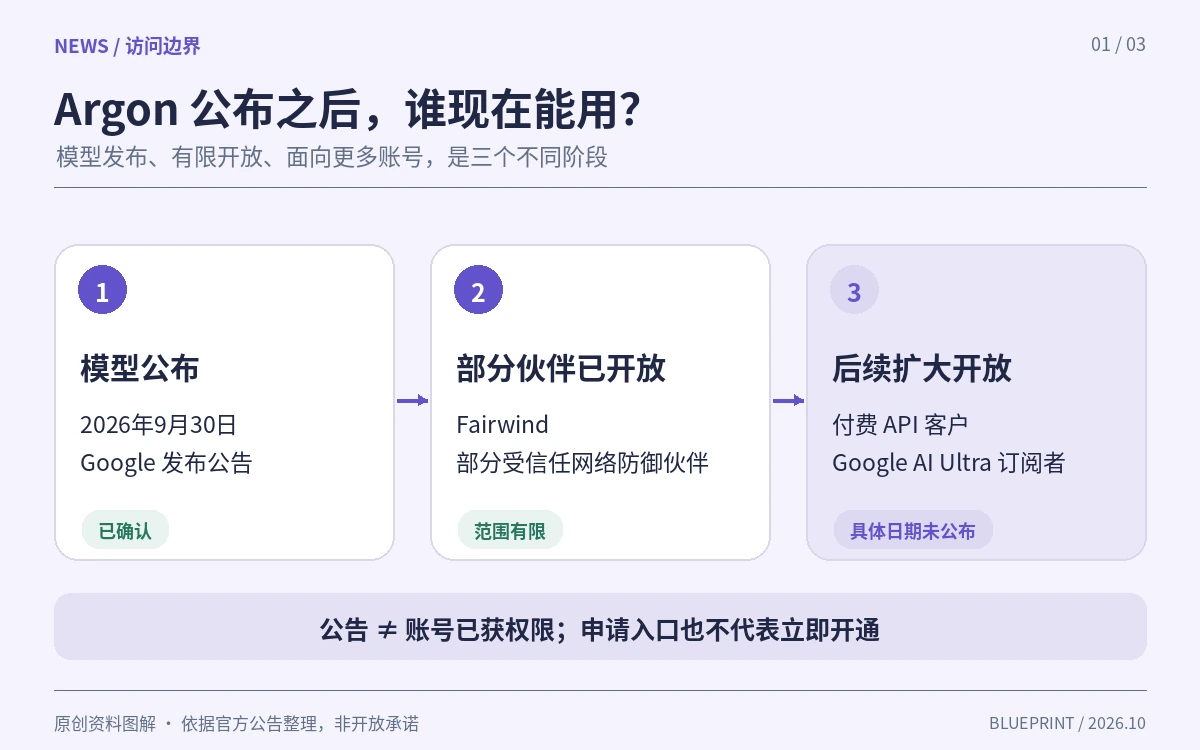
先分清:模型公布和账号可用之间还有一步
目前,Argon通过Fairwind向一部分受信任的网络防御伙伴开放。公告把付费API客户和Google AI Ultra订阅者列为后续扩大开放的起点,但没有写出所有用户都能使用的具体日期。
Fairwind项目页也把Argon权限限定为部分伙伴,并说明可在CodeMender中使用。对普通开发者来说,这意味着“找到模型介绍页”和“自己的账号已有调用权限”需要分别确认。项目的申请入口,也不能当作申请后立即开通的承诺。
我会先保留现在能稳定交付的模型,只把Argon记入待评估名单。等账号出现明确权限,再验证接口、地区和额度;没有必要为了一个尚未确认的入口,提前拆掉已有流程。
价格要看脚注,也要看任务会跑多长
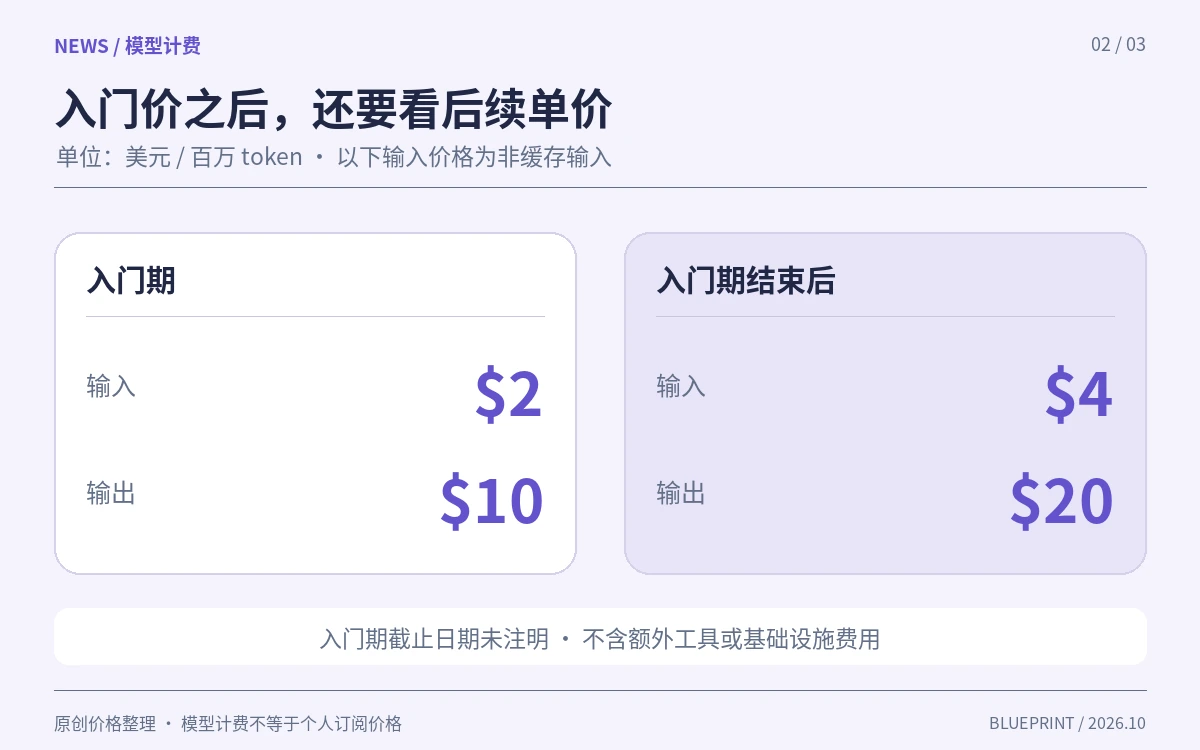
公告给出的入门价是每百万输入token 2美元、输出10美元,缓存输入较输入单价低95%;脚注明确,入门期结束后,输入和输出分别为4美元、20美元。公告未写明入门期结束日期。这里说的是模型计费,不能直接当作个人订阅价格。
举个纯算术例子:假设一次任务计费输入1万token、输出2000token,全部按普通输入、无缓存计算,入门期约0.04美元,之后约0.08美元。这不是实测账单,也未计入额外工具或基础设施成本。
真正容易漏算的是失败后重跑。假如一次任务要反复补充上下文、重新检查资料,最后还要人工修正,单次调用便宜,整件事仍可能贵。我会记录“交付一个合格结果”的总消耗,再和旧流程比较,而不是只看一行单价。
榜单有信息量,但先看它测了什么
Google模型页列出的Argon成绩包括DeepSWE v1.1的77.9%和AutomationBench的51.3%;同一张表中,FrontierSWE v2为55.0%,低于表内GPT-6 Astra的65.5%。这些数字已经提醒我:不同任务的排序会变化,不能概括成全面领先。
再看评测方法说明:除特殊说明外,Argon使用最高思考设置;不同项目的数据来自自测、公开榜单或厂商报告,具体执行环境也有说明。引用分数时,把这些条件一起带上,才知道比较的是哪一种表现。
我的理解是,榜单可以帮助挑选试用方向,但它没有替你测过自己的代码库、中文业务材料和交付时限。尤其是复杂任务,过程能否恢复、结果能否复核,往往比一次漂亮回答更影响团队的使用感受。
真要迁移,我会先留三份小样本
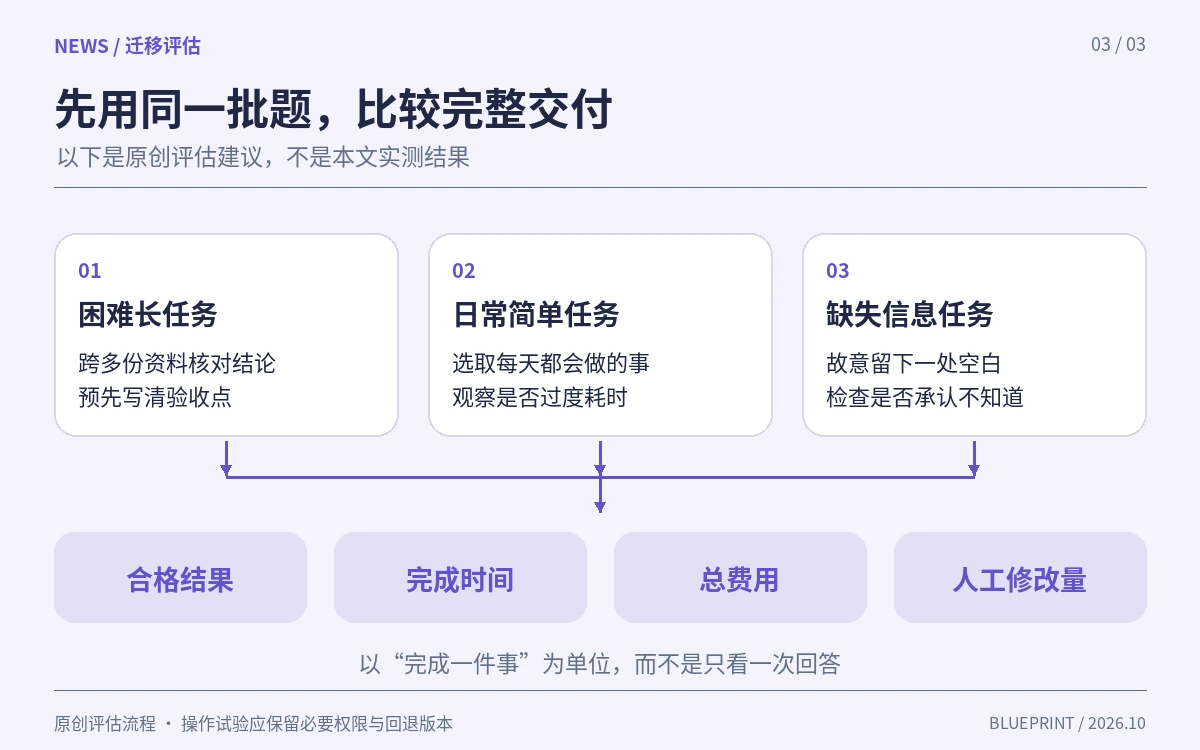
第一份选过去反复失败的长任务,比如跨多份资料核对一个结论,提前写好正确来源和验收点。第二份选每天都会做的普通任务,看它是否为了简单问题消耗太多时间。第三份加入缺失信息,观察它会不会坦承不足,还是编一个看似完整的结果。
每份都记录完成时间、总费用、人工修改量和失败原因。涉及修改文件或外部操作的试验,只给必要权限,并保留回退版本。我的底线很具体:输出好看,却找不到依据或无法撤回,就暂时留在试用阶段。
还有一个我会提前说清的验收规则:测试开始前就写好什么算完成。资料任务要列齐关键依据,代码任务要通过已有测试,业务写作要保留必要的条件和例外。不要看到新模型写得更流畅,就临时放宽标准;也别把旧模型人工修过的成品,和新模型未经修改的初稿放在一起比较。
小团队也不用一开始就搭复杂评测系统。一张记录表,加上同样的输入、明确的预算上限和可复查的结果文件,已经能避免不少主观误判。碰到某类任务改善明显,就先让它承担这一类;如果优势只出现在偶然的一次回答,继续收集样本更合适。这样的渐进替换也方便保留原流程,避免上线后出现问题时无处回退。
这次发布,值得关注的是什么?
我看重的是Google把竞争重点继续推向可持续执行的专业任务。对读者来说,更实用的准备是整理自己的测试题和成本记录。等访问范围与计费条件真正明确,再用同一批任务做对照,迁移决定会比追着发布标题走稳得多。
资料来源
- Google:Introducing Gemini 4 Argon(2026-09-30)
- Google DeepMind:Fairwind Program
- Google DeepMind:Gemini模型与基准成绩
- Google DeepMind:Gemini 4 Argon评测方法
资料核对日期:2026年10月6日。官方披露与编辑建议已在文中分别说明。