这轮 OpenAI DevDay 更新里,我最想替普通开发者拆开的,是 GPT-6.1 Sol 的价格。旗舰能力当然值得看,但一个每天要处理几百份材料、反复修改代码的团队,更关心的往往是:这个模型能不能长期用得起,而且不把省下的钱花在返工上。
9月29日发布的 GPT-6.1 Sol,被 OpenAI 定位为接近 Astra 能力、成本更低的工作模型。下面根据截至2026年10月2日的官方资料梳理;性能数据属于厂商评测,文中的选型建议是我的编辑判断,没有冒充独立实测。
先把“五分之一”说准确
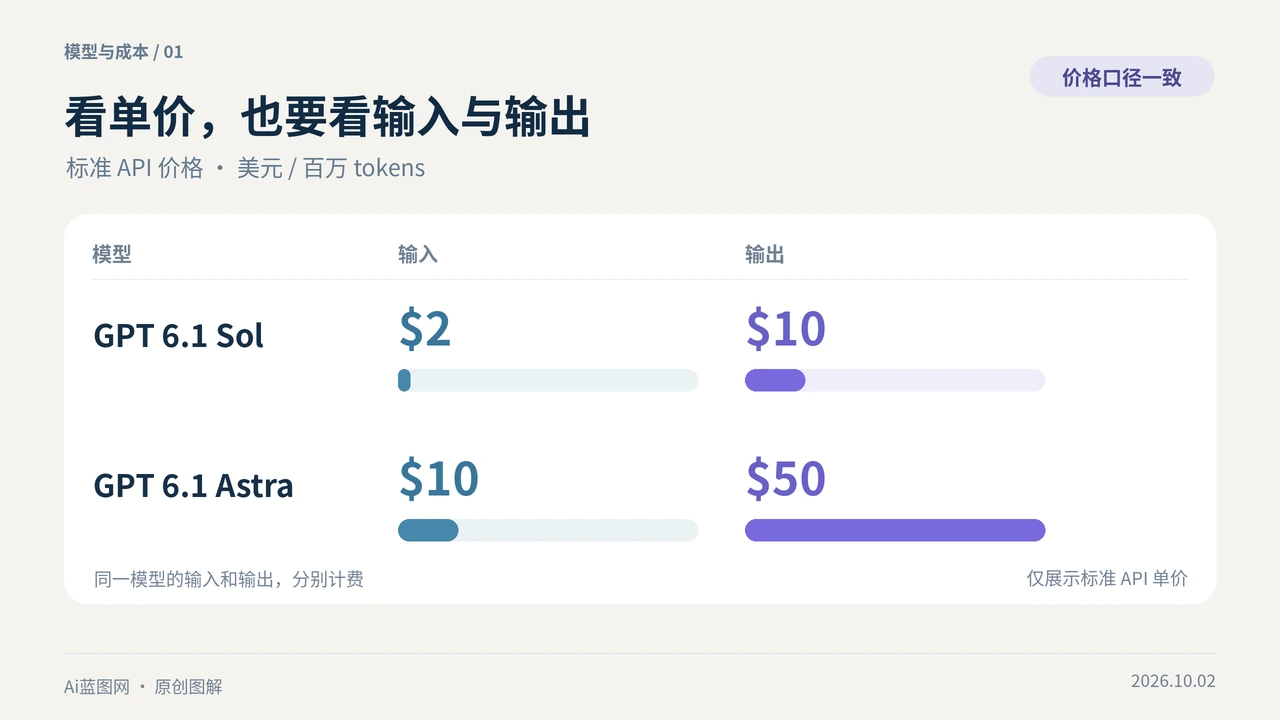
官方模型目录列出的标准 API 价格,以每百万 token 计:Sol 输入2美元、输出10美元;Astra 输入10美元、输出50美元。因此,“五分之一”比较的是标准输入和输出单价,不能直接当成所有任务的最终账单比例。查看官方模型与价格目录。
缓存输入也值得单独看。发布公告给 Sol 的缓存输入定价是每百万 token 0.10美元,较上一代 Sol 减半。对经常复用长背景的工作流,这是一个值得测试的变化,但缓存是否命中、一次任务要来回多少轮,仍会影响实际支出。查看发布公告。
我会把模型账单和交付成本分开记。比如一篇资料汇总,第一次生成便宜,却漏掉关键日期,接着需要两次追问和人工校对;另一种方案单次略贵,一次就能交付。对内容团队来说,后者完全可能更划算。这里是假设场景,不能拿来证明某个模型一定占优。
性能进步,要连评测条件一起读
OpenAI 公布的结果显示,Sol 6.1 在复杂编程、电脑操作和专业工作上提升明显。例如在 OSWorld 2.0 离线集、最高推理强度下,成绩距 Astra 为2.1个百分点,平均任务成本约为其七分之一。这个数字有参考价值,但它对应指定数据集和设置,不是日常电脑任务的通用成功率。官方也提醒,研究环境与实际产品的工具、提示及设置可能不同。
我读这类成绩时,会先问自己的任务是否相似。修复一个已经写好验收测试的代码问题,与从零理解一套陌生业务规则,难点很不一样。分数接近,说明值得加入候选名单;能否替换现有方案,还要拿自己的样本看。尤其是漏项比文笔更致命的工作,平均分容易掩盖少数严重错误。
Ultrafast 是另一笔速度账
模型更新和速度档位容易被混在一起。截至本文核对时,OpenAI 的入门资料列明 Sol 支持 Standard 和 Fast,Sol Ultrafast 仍为后续推出;Astra Ultrafast 已提供。Sol 可用于支持的付费方案中的 Work、Codex 及 API,尚未进入普通 Chat。企业和教育工作区还需核对管理员配置。查看官方可用性说明。
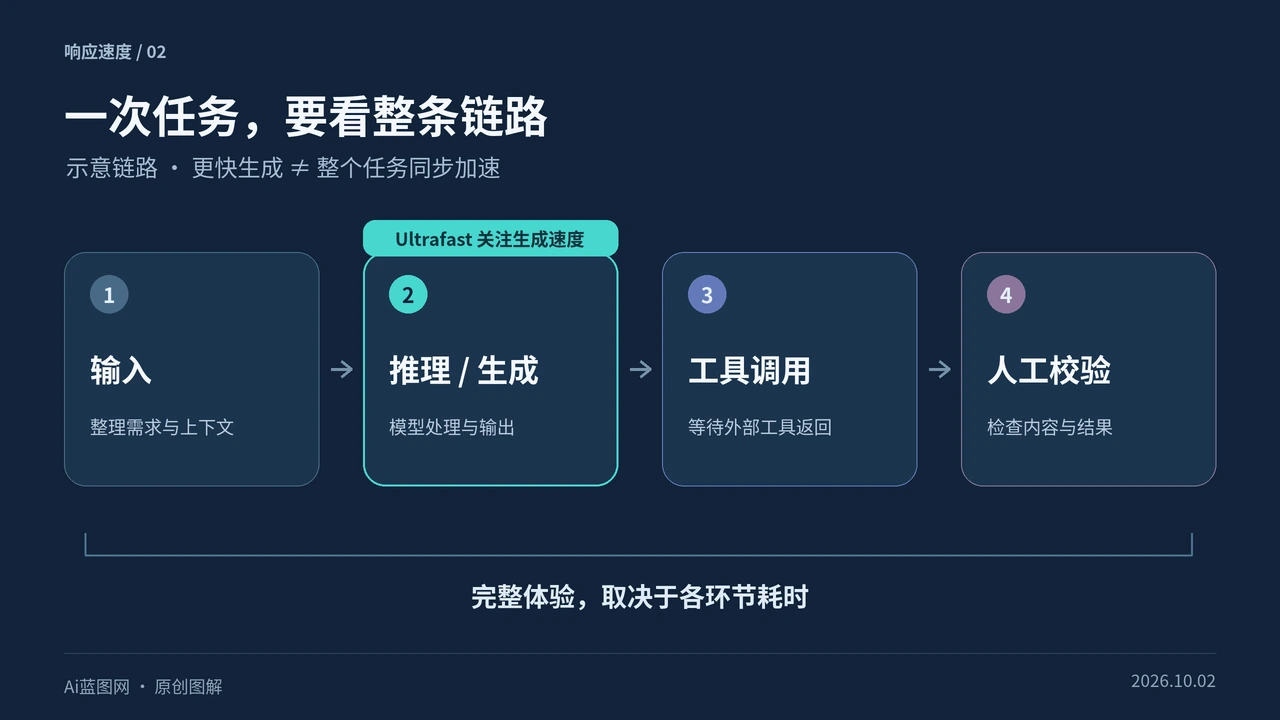
Ultrafast 文档把它定义为更高成本的服务档位,并建议高频工具调用场景使用持久连接,减少网络开销。这提醒我,生成更快不代表报告按相同比例提前交付。网页响应、文件读写、外部服务和人工审核,都可能成为新的等待点。查看 Ultrafast 官方文档。
我的建议:先做一次小规模替换实验
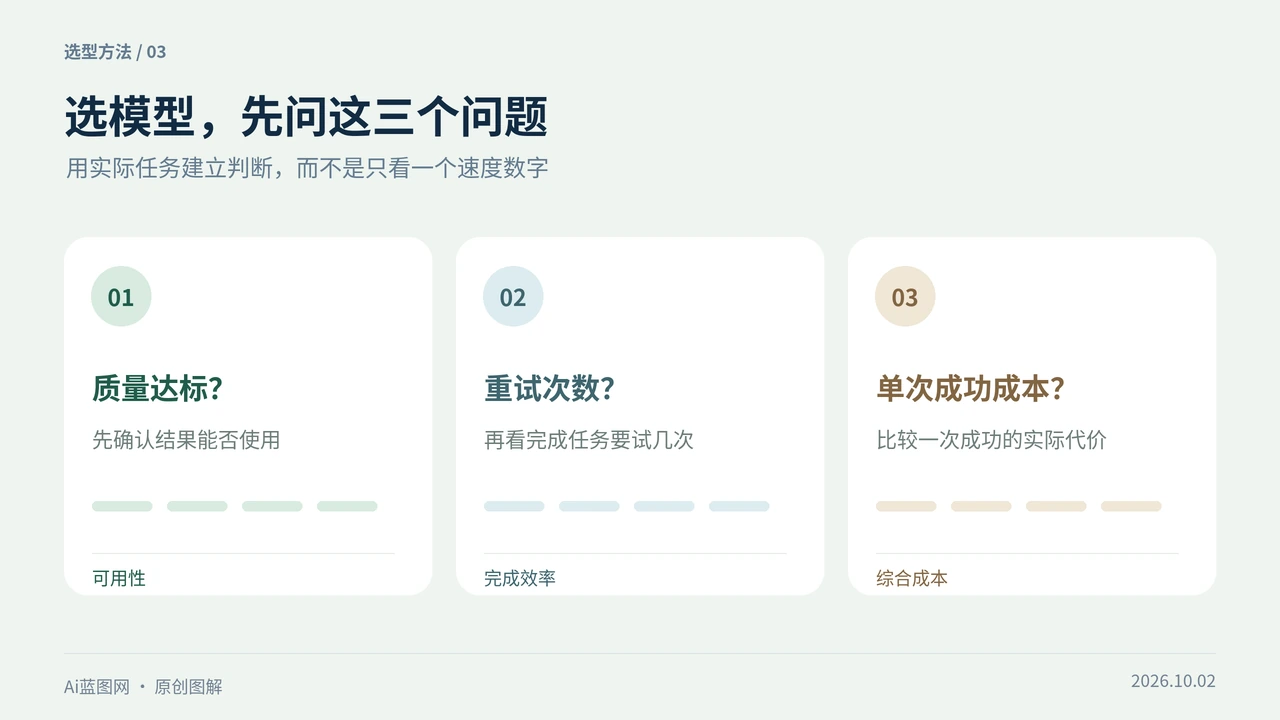
如果你正在评估它,我建议选十个最近真实做过的任务,事先写清验收标准。资料任务检查事实和出处,编程任务跑原有测试,自动化任务核对每一步结果。保持输入材料和权限一致,再比较质量、返工次数、总耗时与费用,不要边测边修改标准。
我还会把试用范围限制在可以回滚的任务里。先做内部草稿和可检查的代码改动,把涉及客户承诺、付款或对外发布的步骤继续留给人审核。模型能力提升后,最容易被忽视的是权限并没有自动变得合理;省下几秒钟,也不足以抵消一次越权操作带来的麻烦。
预算上可以设一个小额试验上限,并提前约定退出条件。连续漏掉同类关键信息,就先排查输入和流程;表现稳定再扩大任务量。这是我建议的验证方法,不是官方对效果的保证。
还要留一份失败记录。模型是没看懂要求、缺少工具权限,还是被格式细节绊住?这些原因对应不同改法。把所有失败都算成“模型不行”,容易错过流程问题;只展示最漂亮的样本,也会让预算估得过于乐观。
我对这次更新的判断是:更低的标准单价,让复杂工作有了一个值得认真比较的新选项。真正值得升级的时刻,是它在你的验收标准下稳定交付,节省的费用足以覆盖迁移和审核。先让账单与结果说话,再决定哪些任务交给 Sol、哪些继续保留更强模型,会比追着型号换工具更稳妥。