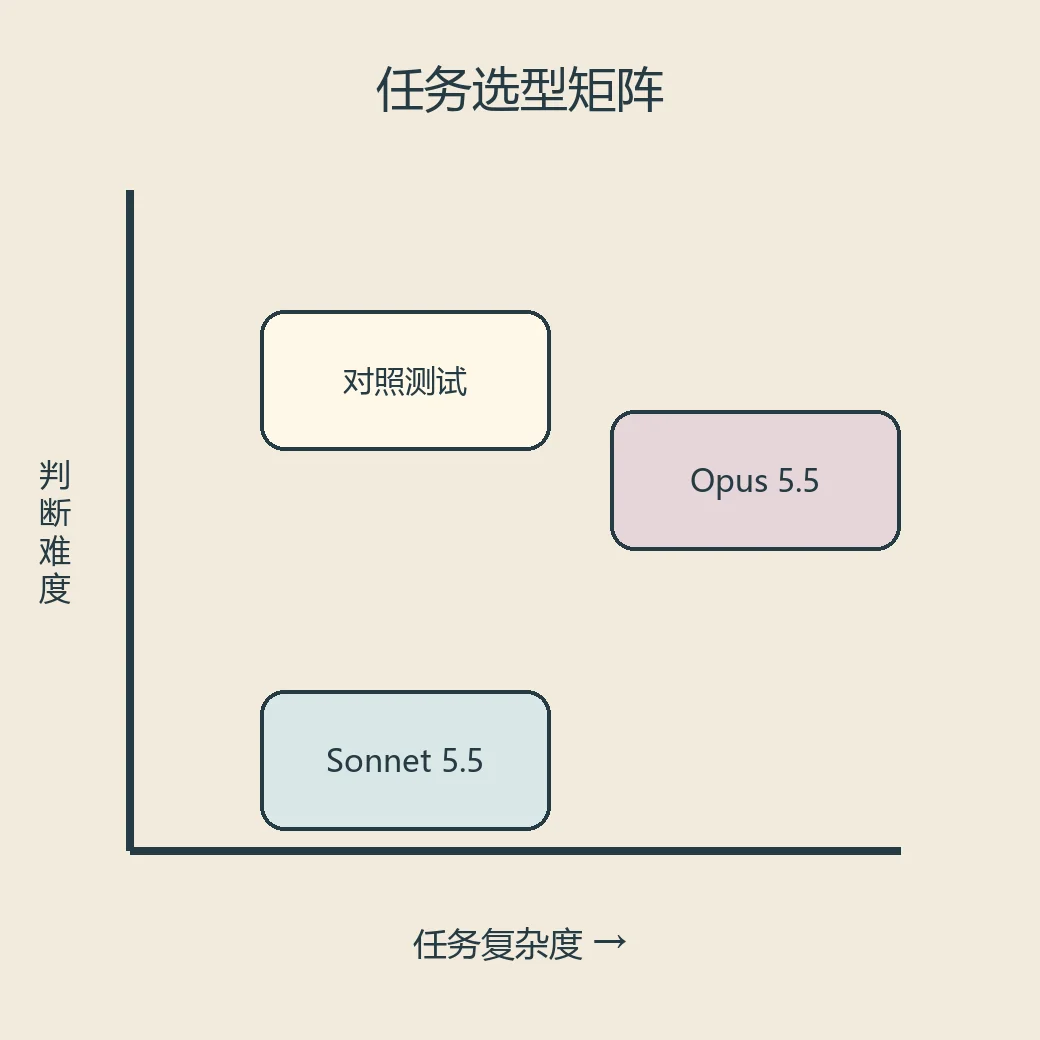
9 月 28 日,Anthropic 发布 Claude Sonnet 5.5。官方给出了两个很抢眼的说法:输出速度提升 30% 以上,多数任务的成本最高降低 30%。如果你只想知道要不要换,我的结论很直接:日常编码、明确范围的知识工作和频繁迭代可以优先试 Sonnet 5.5;高风险、开放式且需要持续判断的任务,仍要和 Opus 5.5 对照。
资料核查日期:2026 年 10 月 1 日。本文的价格、速度和可用性均来自 Anthropic 官方发布页;产品与时间列表参照 Anthropic Newsroom。这些都可能继续变化。
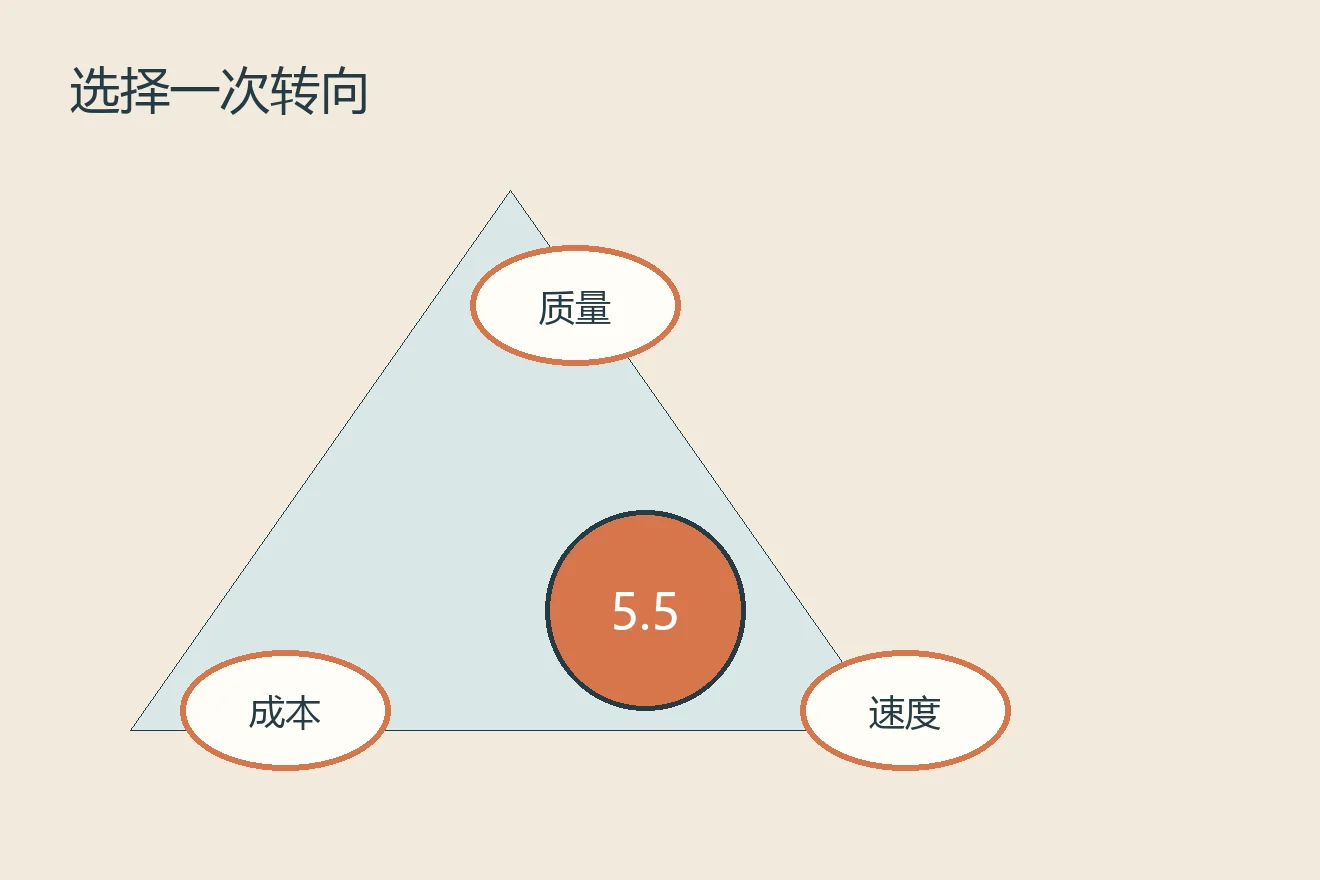
先把“快 30%”和“省 30%”分开看
速度是生成输出的体感,成本则同时受单价、输入输出 token、缓存和任务是否一次做对影响。Anthropic 说 Sonnet 5.5 的输入与输出单价沿用 Sonnet 5:每百万输入 token 2 美元,输出 10 美元,缓存读取 0.20 美元。所谓“每任务最高便宜 30%”,主要来自用更少步骤和更少 token 完成同一件事,并不代表你的账单会自动下降固定比例。
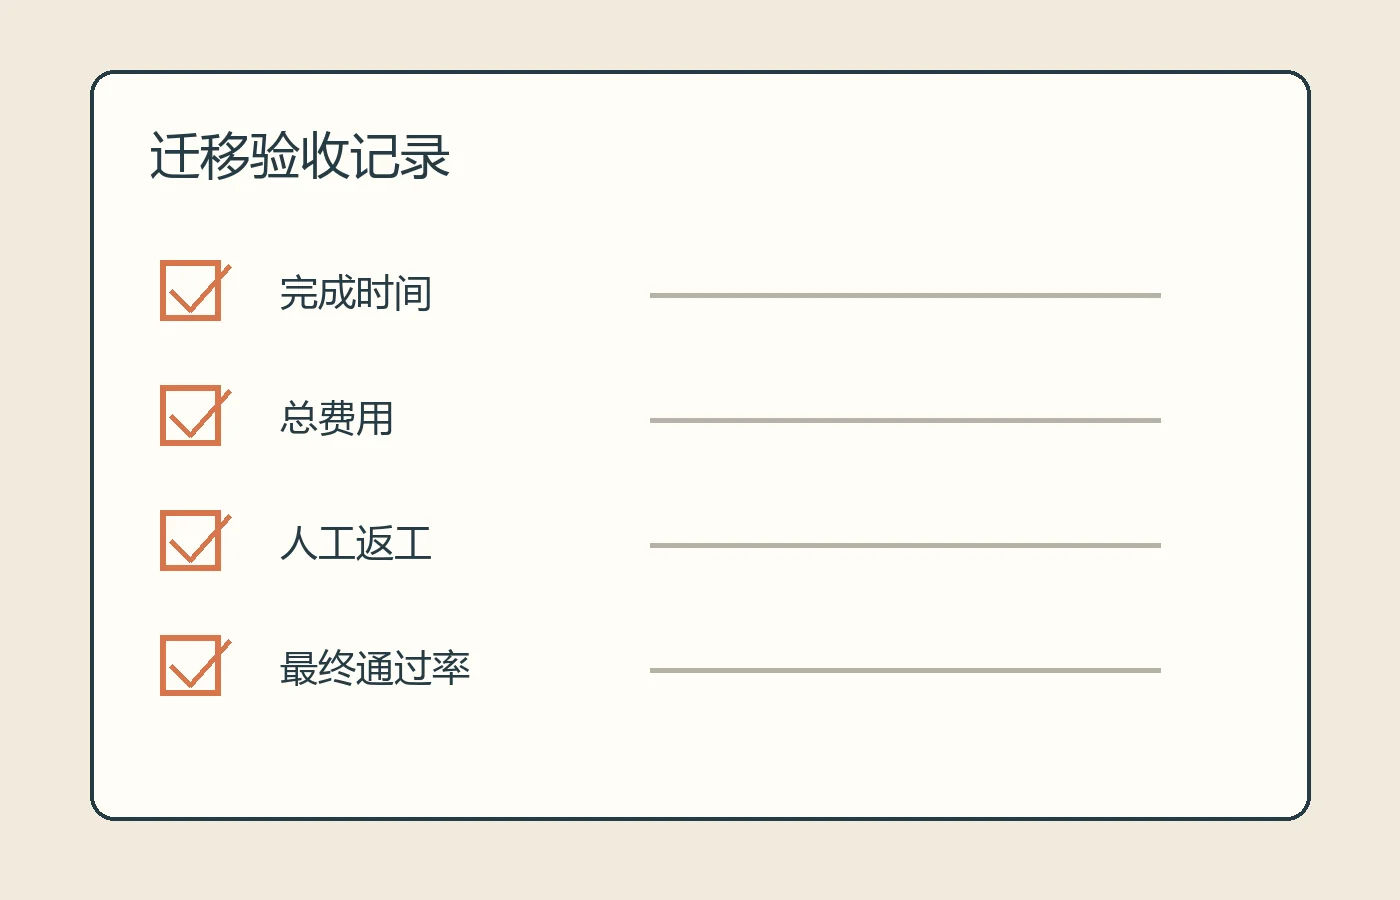
我会先选 20 个真实任务,用相同输入、工具和验收标准跑旧模型与新模型。记录完成时间、总 token、重试次数、人工修改量和最终通过率。只看出字速度,很容易忽略后面的返工。
Sonnet 5.5 更适合哪些任务?
| 任务 | 我的选择 | 理由 |
|---|---|---|
| 明确的 bug 修复、小型功能 | 优先 Sonnet 5.5 | 官方将其定位为日常编码和范围清晰的工作 |
| 文档、幻灯片、表格初稿 | 优先 Sonnet 5.5 | 速度快,适合多轮局部调整 |
| 架构决策、模糊多方约束 | 对照 Opus 5.5 | 官方仍认为 Opus 在开放式持续判断上更强 |
| 大量、低复杂度请求 | 等待或对照 Haiku 5.5 | 成本敏感场景不要只在 Sonnet 与 Opus 间选 |
官方跑分能告诉我什么?
发布页给出了 Terminal-Bench、FrontierCode、CursorBench 和知识工作测评。它们能说明新模型在官方选定的任务上进步明显,但不能替你回答“我的仓库、文档和工具链是否更稳”。官方也明确提醒,基准只是能力的一个切面,高 effort 也不总是更好,有的测试会因过度扩展任务而失分。
我会怎么做小规模验证
- 固定任务说明、输入文件和可用工具。
- 先用默认 effort,再为少数高风险任务调高。
- 使用事先写好的验收标准,避免看到答案后才改标准。
- 保存总耗时、费用、失败类型和人工修改时间。
- 把表现差的样例回放,判断是模型、提示词还是工具配置问题。
迁移前别忽略这三件事
第一,开发者的模型名称是 claude-sonnet-5-5,迁移时要查 SDK、模型允许列表和观测仪表。第二,如果你以前关闭 thinking,官方要求切换到新的 between_tools 设置,不要原样复制旧参数。第三,网络安全与生物类任务会触发特定保护和回退,专业团队要按官方项目申请合适权限。
限制说明
我没有在你的业务数据和仓库上做对照实测,因此不会把官方数字当成你的实际结果。价格、区域、云平台与保护策略都可能变化,正式迁移前请再查当日文档。
FAQ
Sonnet 5.5 单价比 Sonnet 5 低吗?
输入和输出标价没有下调。官方所说的单任务降本,主要来自用更少 token 和步骤完成任务。
日常工作是否都应该换到 Sonnet 5.5?
可以小范围优先试,但我建议保留高风险任务的对照集,用通过率和返工量决定是否全量切换。
effort 越高越好吗?
不一定。范围明确的任务可以先用默认设置,只给需要更多检查的少数任务提高 effort。