AI帮你把代码写出来了,合并请求却一直等测试。这时候再优化提示词,可能帮不上忙。我会先看任务在哪排队:等待机器启动、测试本身太慢,还是测试结果没有及时进入后续系统?这几个问题需要不同的处理办法。
我的建议:先测量队列与结果延迟,确定瓶颈,再调整并发和测试选择。不要为了绿色状态直接减少检查。本文资料核验日期为2026年9月16日,借鉴Anthropic的官方工程复盘;排查步骤为编辑建议,没有在你的CI环境进行实测。
为什么代码写得快,等待反而变长?
Anthropic在9月14日的工程复盘讨论了AI辅助开发增加任务量后,测试影响分析服务承压的问题。这个服务负责根据相关性和历史结果选择测试,结果记录跟不上时,选择依据就会变旧。
我想提醒的是:流水线上可能有多个队列。你看到PR在等待,不能直接推断所有机器都不够用。也可能是一个收集结果的环节只允许单个处理进程,后面系统一直等它更新。
第一步:把一次提交的时间线记清楚
- 提交或PR触发时间。
- CI任务进入队列的时间。
- 执行开始与结束时间。
- 结果被记录、检查状态被更新的时间。
同一批任务的时间戳放在一起,你就能初步区分排队耗时、执行耗时和结果传播耗时。先选一个有代表性的时间窗口,避免只看恰好失败的一次运行。敏感日志应脱敏,记录中也别带访问凭据。
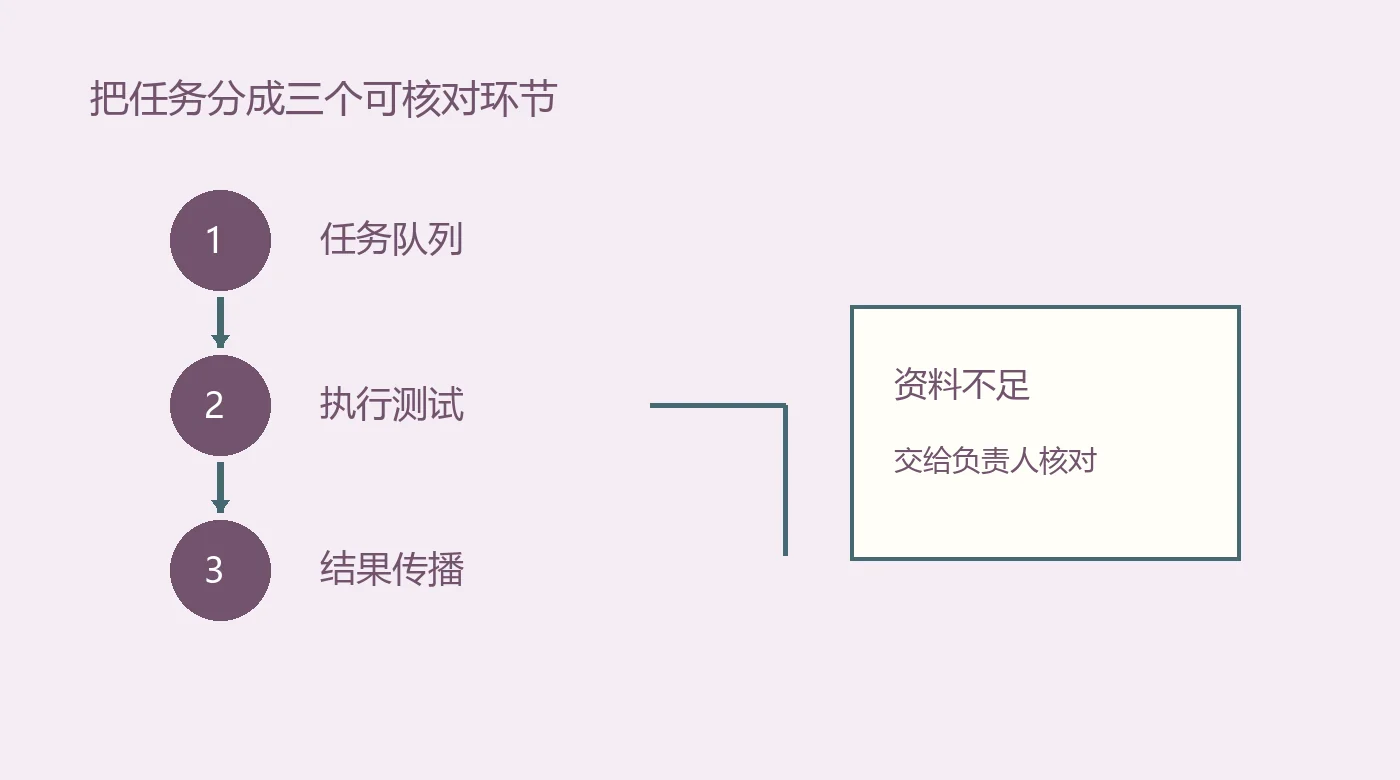
第二步:区分三类常见卡点
| 观察到的现象 | 先查什么 |
|---|---|
| 等待执行时间很长 | 执行器容量、并发限制、突发任务量 |
| 任务启动快但执行慢 | 慢测试、依赖下载、重复构建 |
| 执行结束但状态更新慢 | 结果监听、消费队列、下游更新 |
这张表是排查入口,不能代替监控数据。比如依赖下载慢与执行器不足可能同时出现;先核对时间线,再决定哪个改动能直接缓解当前问题。
第三步:检查测试选择依据是否及时
如果团队使用测试影响分析,我会追问:最近新增或修复的测试何时被纳入选择?失败历史更新是否滞后?这是因为选择测试本身也依赖数据,不应把选择器当成始终正确的黑盒。
可以用已经知道会触发某个测试的变更进行核对,确认该测试确实被选择,并检查结果进入历史记录的时间。对关键模块保留完整验证路径;不确定时宁可扩大验证范围,也别静默漏掉检查。
第四步:临时缓解与架构改进分开验收
提高容量或重启进程可能缓解当前积压,但你还需要判断积压是否又持续增长。Anthropic的复盘讲述了多次临时修补后转向可横向扩展处理的经历。具体架构不能照搬,重点是看状态管理和处理能力能否跟上任务增长。
- 临时措施:明确观察窗口和恢复条件。
- 长期修改:明确维护负责人和容量目标。
- 发布验收:同时检查延迟与结果完整性。
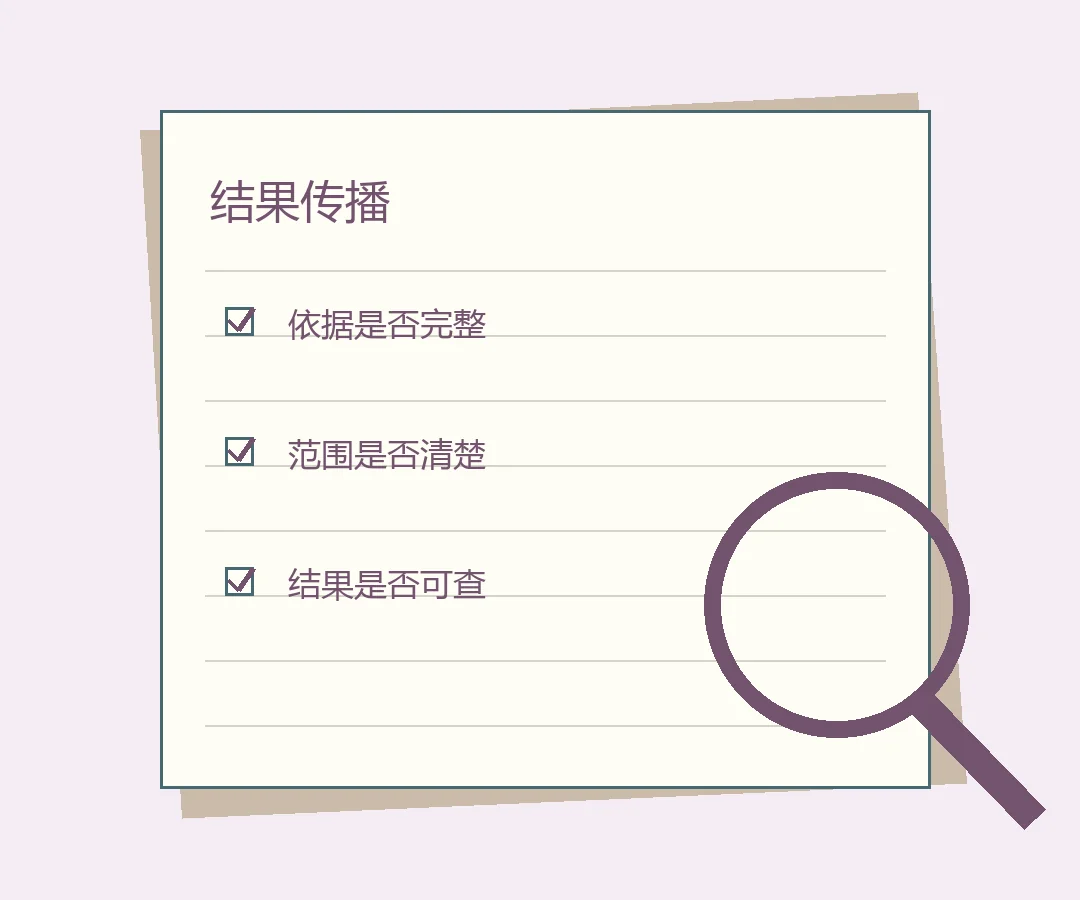
第五步:把AI的任务范围和停止条件写明白
让AI协助排查时,我会把任务限定为“解释脱敏时间线、指出需要补的证据、准备修改方案”。任何修改都应回到版本控制和正常审查。AI不应该为了让队列变短,自行跳过测试、改保护规则或把失败状态隐藏起来。
你可以这样提问:“这里是一次CI运行的时间线和队列数据,请区分排队、执行和结果传播耗时,列出最可能的瓶颈与下一步验证;资料不足时说明缺什么。”这是建议提示词,是否适合还取决于你提供的真实监控。
FAQ
增加机器就一定能解决吗?
只有瓶颈确实在执行容量时才可能直接有效。单进程结果收集或下游延迟需要另查。
应该让每次提交都跑所有测试吗?
取决于项目规模与风险。使用测试选择时,需要验证选择依据和关键模块的完整检查路径。
排队变短算修复完成吗?
还要确认测试结果没有丢失、选择依据及时更新,且在代表性负载下保持稳定。