如果只看标题,这条消息很容易被理解成“又有学校给学生发AI账号了”。但我把OpenAI在2026年9月8日发布的公告读完后,反而觉得重点不在账号数量,而在新闻专业准备怎样把AI放进真实工作流里:能不能更快查资料是一回事,最后由谁判断、怎样核对、什么内容不能交给模型,是另一回事。
先说事实。OpenAI宣布与纽约市立大学Newmark新闻学院的Tow-Knight Center,以及西北大学Medill新闻学院的Knight Lab合作,面向2026—2027学年,为感兴趣的研究生和教师提供400多个ChatGPT Edu席位。官方把这项工作描述为一套面向新闻生态的工具、培训、合作和实践支持计划,而不只是一次产品赠送。
这条新闻到底说了什么
按照OpenAI官方公告,参与者会在新闻教学和实践中探索AI:分析公共记录、检索档案、翻译内容、寻找数据中的模式、头脑风暴,以及尝试新的叙事形式。公告同时反复强调记者、编辑、制片人和新闻管理者的核心角色仍然要保留。
我把这项计划拆成三层,会更容易理解:
| 层次 | 实际内容 | 我认为该看的指标 |
|---|---|---|
| 工具接入 | 400多个ChatGPT Edu席位 | 多少人真正持续使用 |
| 方法训练 | 把AI放进采访、资料和数据流程 | 有没有可复查的操作规范 |
| 行业反馈 | 学校、媒体与OpenAI交流经验 | 失败案例是否公开讨论 |
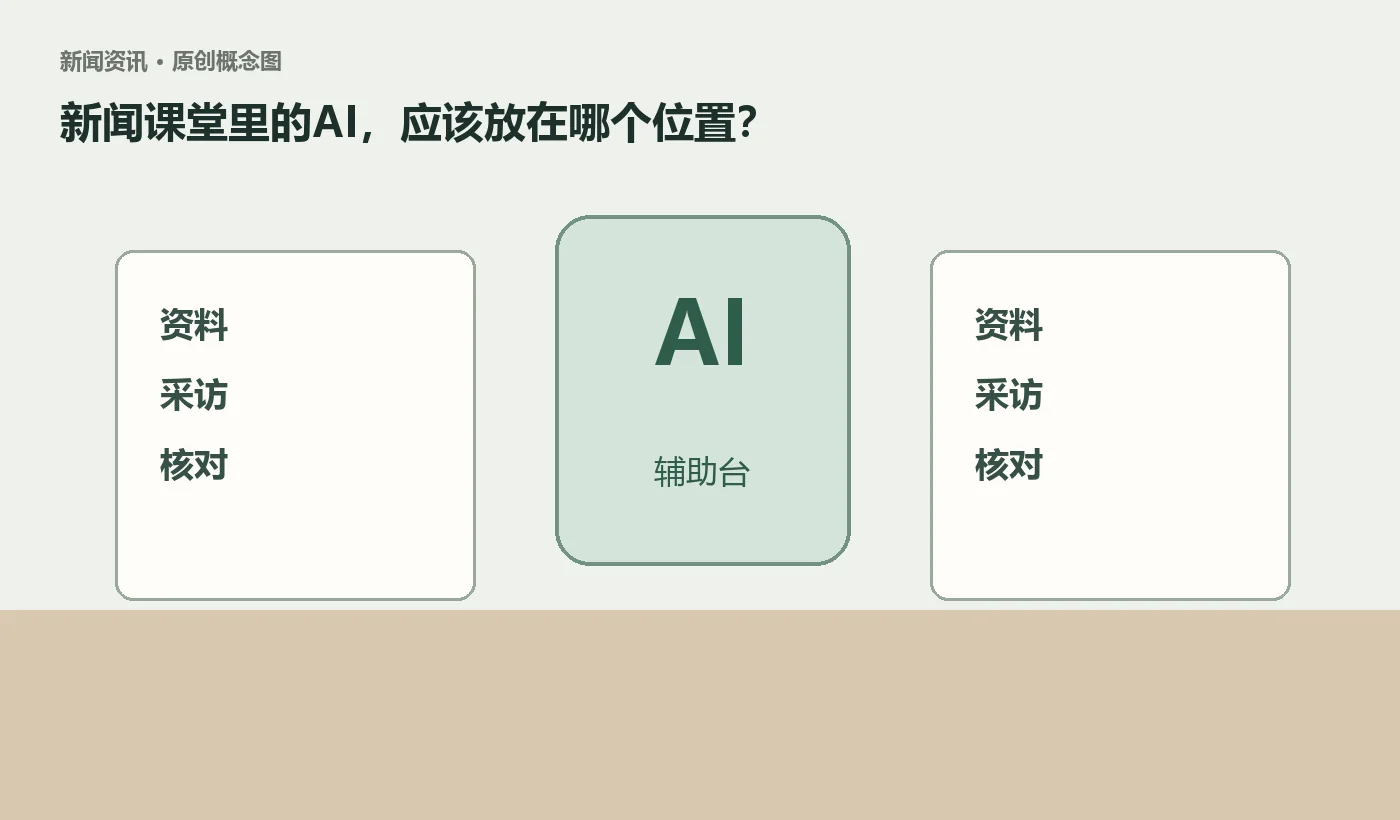
数字当然醒目,但决定结果的还是后两层。学生如果只学会“让模型给答案”,这种训练很快会过时;如果学会标注来源、保留查询过程、识别不确定信息,换任何模型都还能用。
我更关心的,是新闻教学会不会补上核对环节
新闻工作对事实、来源和责任链要求很高。AI可以把几百页材料先分组,也可以帮忙列出采访问题,但它无法自动证明结论真实。我的理解是,这次合作真正有价值的部分,是让学生在进入编辑部之前就碰到这些问题,而不是工作后才补课。
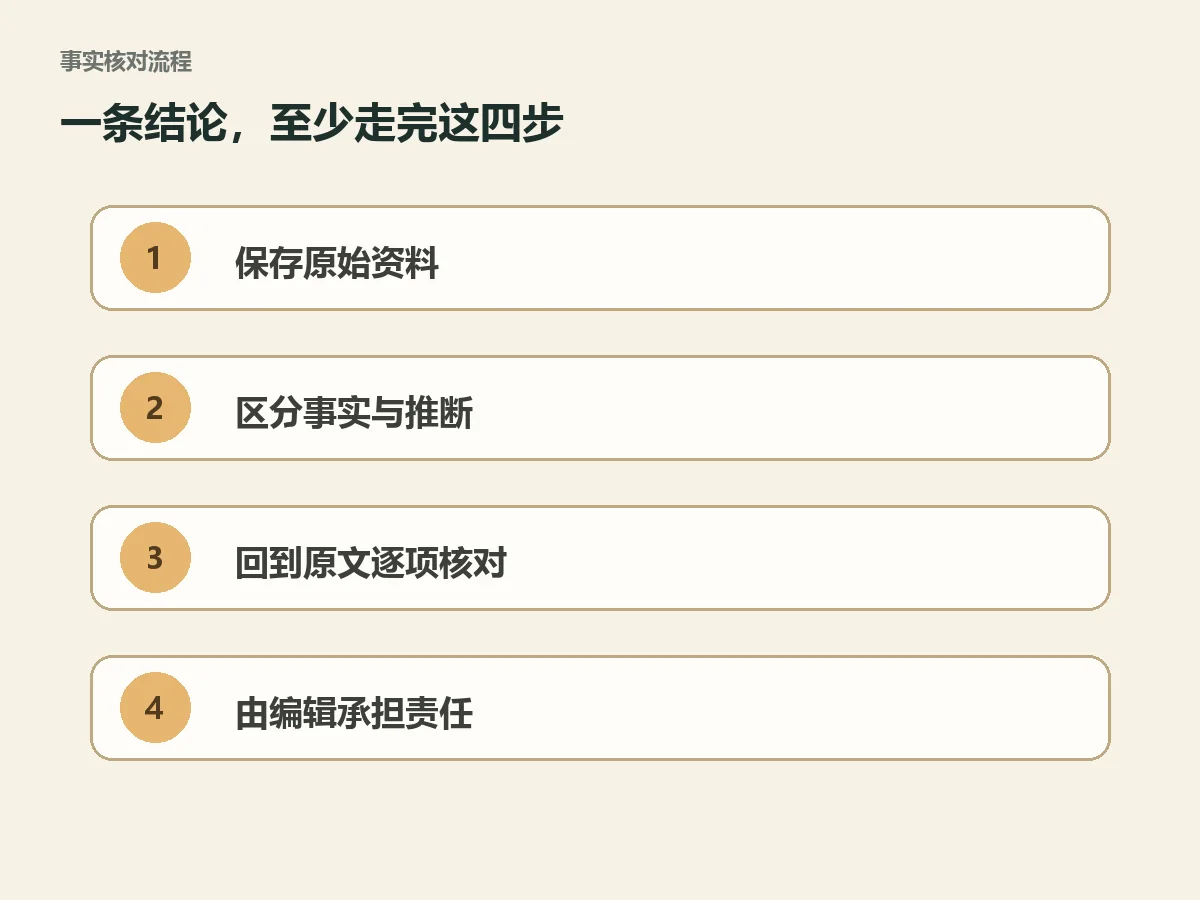
我会建议一堂AI新闻课至少保留下面四个动作:
- 记录原始资料从哪里来,并保存访问日期;
- 把模型生成的事实、推断和建议分开;
- 对人名、日期、数字和引语逐项回到原文;
- 涉及隐私、未成年人或敏感采访时,先看组织政策再决定能否上传。
这种训练看起来慢,其实是在减少返工。最费时间的情况往往发生在发布前:出处不清、数字对不上,最后整篇重查。
这不等于新闻生产已经能自动化
官方公告给的是合作方向,没有公布课程大纲、学习成果或长期评估数据。因此,目前能确认的是项目启动、合作机构、席位规模和预期应用,不能据此断言学生写稿速度一定提高,也不能说AI已经替代了某类新闻岗位。
另外,ChatGPT Edu提供面向学校的隐私、权限和管理控制,官方说明Edu工作区数据不会用于训练OpenAI模型。但具体学校怎样配置权限、哪些材料允许上传,仍要看校方制度。产品层面的承诺不能替代编辑部自己的数据分级。
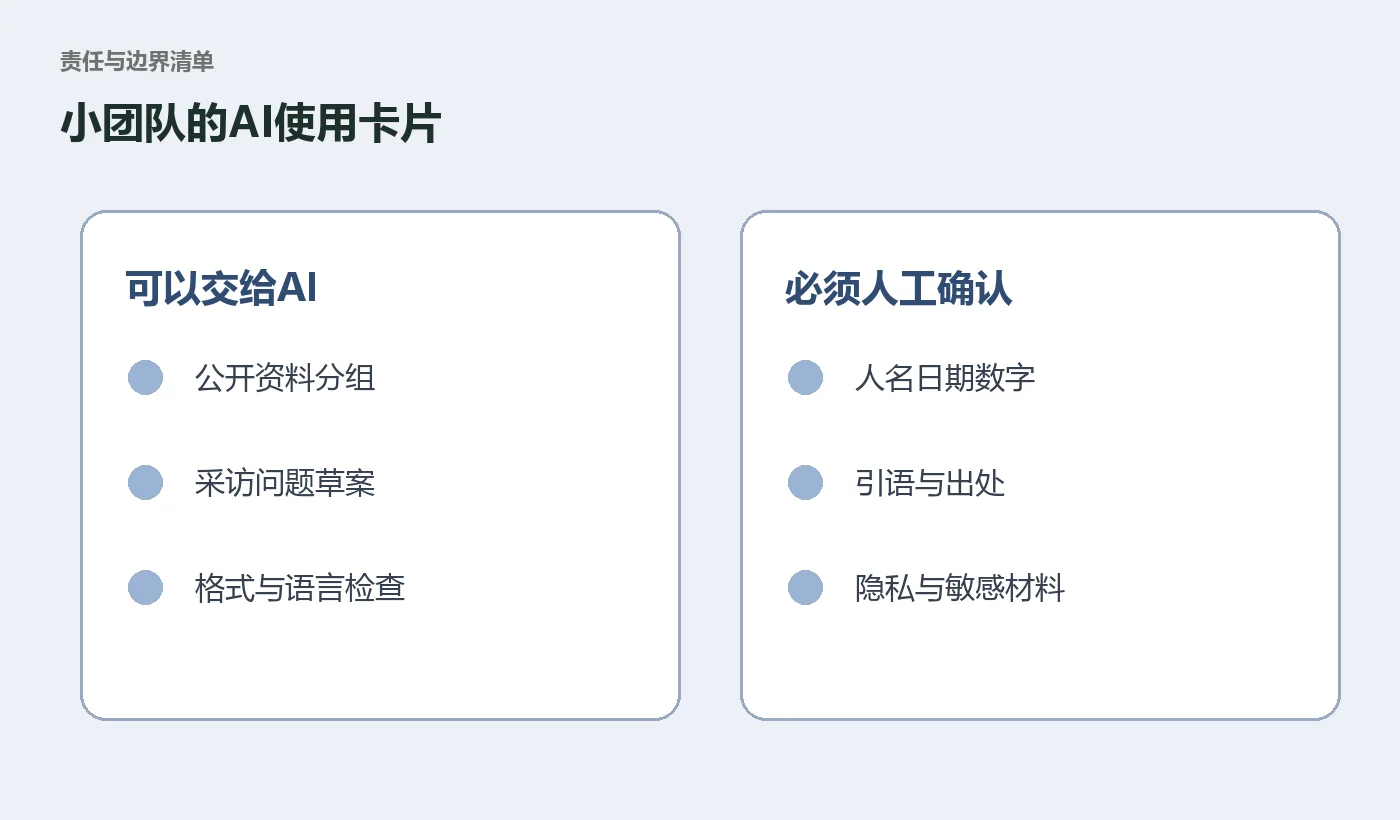
对普通内容团队有什么启发
我觉得小团队最值得抄的是先做一张AI使用卡片,而不是照着买同样的账号:哪些任务可用、输出怎么验、谁负责签字。比如AI可以先整理公开材料,但涉及事实陈述的句子必须附来源;AI可以改写标题,但不能把未经证实的推断写成结论。
这套办法也适合自媒体。工具再强,读者最终记住的还是内容是否可靠。把“生成”当起点,把“核对”当必做步骤,AI才可能真的节省时间。
常见问题
这次计划覆盖哪些学校?
首批合作方是Newmark新闻学院的Tow-Knight Center和西北大学Medill新闻学院的Knight Lab,官方表示还会推进更多阶段。
400多个席位意味着所有学生都强制使用吗?
不是。公告的措辞是向感兴趣的研究生和教师提供席位,没有说所有人必须参加。
AI生成的新闻内容可以直接发布吗?
这条公告没有给出“一键发布”的授权。实际发布仍应遵守学校或媒体机构的编辑、事实核查、署名和隐私规则。