可以。Buzz支持本地语音识别,也能导出SRT、VTT字幕;处理中文时应选多语言模型。本文截至2026年10月18日核对官方资料,属于功能评估,未做录音实测,不承诺准确率或处理速度。
离线成立的前提是什么?
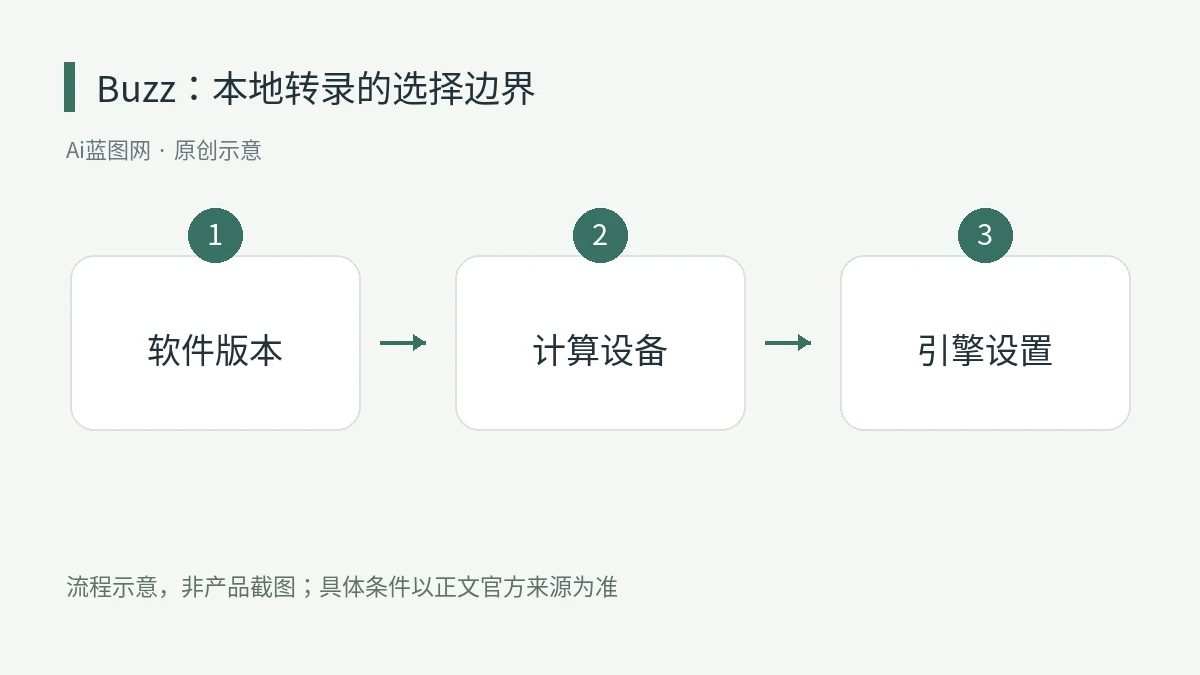
先安装程序、下载模型,再导入电脑里的录音。想保留中文,应选Transcribe,而非Translate to English;名称带.En的模型仅适用于英语。官方FAQ说明,模型大小影响资源需求与效果。
Buzz也支持远程API。若选择该路线,音频识别就不在本机完成;设置中的Base URL决定请求目的地。需要保密的素材,使用前应检查后端、翻译和摘要插件,不能仅凭“离线工具”四字判断。见设置说明。
版本、费用和电脑要求怎样看?
开源版采用MIT许可,可免费获取,提供Windows、macOS和Linux安装途径;API费用另按服务商规则核对。旧版官方介绍另有Mac原生商店版Buzz Captions,但其链接本次返回404,无法确认当前上架状态、售价和系统要求,勿套用同名应用的信息。
发布页当前最新标记为v1.4.5;主分支README的“About Buzz安装CUDA”写明针对待发布的1.4.6及以后,不能当成1.4.5现成功能。README也将1.4.5列为最后支持Intel Mac的版本,下载前应核对芯片架构。
适合谁,怎样开始?
适合愿意人工校对的采访整理者、课程记录者和视频作者。建议先拿一分钟非敏感录音试跑:选择中文和本地多语言模型,导出SRT,再对照音频检查人名、数字、漏句及时间轴。模型准备完成后,可断网复测这段本地文件,确认所选流程能运行。
若速度难以接受,先尝试较小模型,记录耗时与错误再决定是否更换。方言、噪声和多人重叠讲话应单独抽查;自动转写适合生成初稿,字幕发布前仍需逐段校对。