微软Smart DRI Agent案例最值得借鉴的做法,是把故障发生后的资料搜集集中起来,让值班工程师更快拿到排查依据。对准备做运维AI的团队,第一步可以从“少找资料”入手,再评估是否有条件扩大自动化范围。
官方案例:把散落的信息送到工程师面前
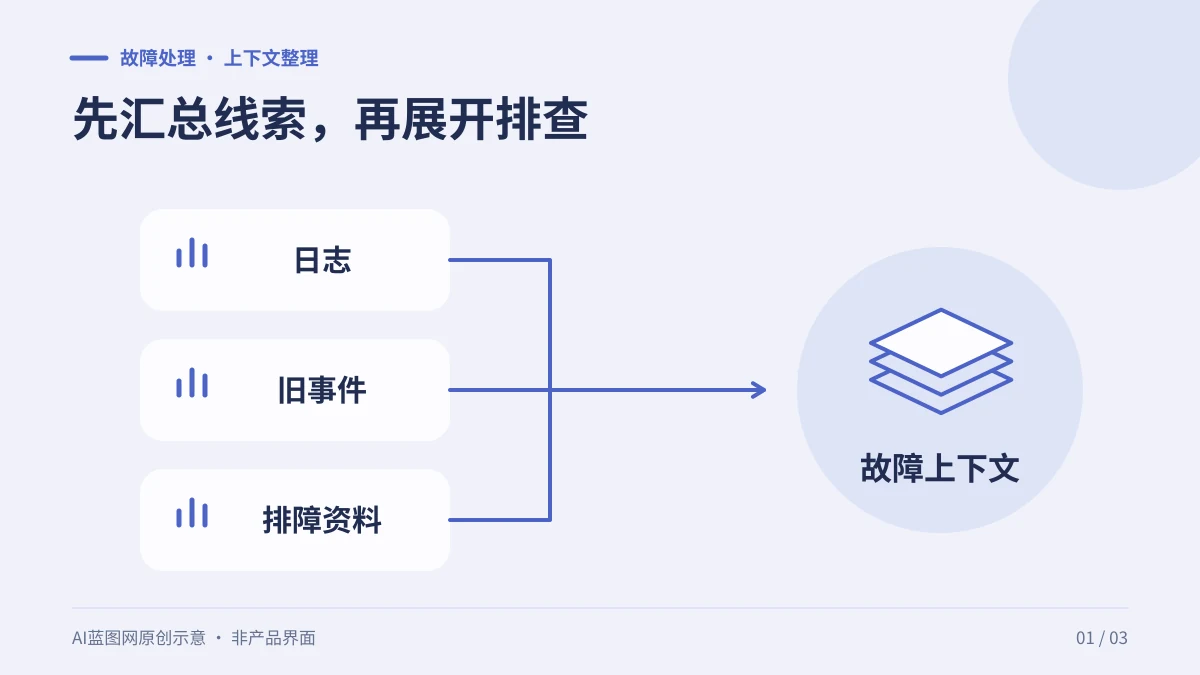
微软在2026年10月15日发布的官方案例中介绍,DRI指轮值负责线上服务的工程师。故障信息原本分散在门户、监控和排障文档中,交接时还容易遗漏背景。
Smart DRI Agent把近期日志、相似事件和排障建议送到Teams。团队用Semantic Kernel协调工具调用,并在Azure AI Search检索之上加入相似性判断逻辑;不同团队的交接要求则改用可配置模板承接。
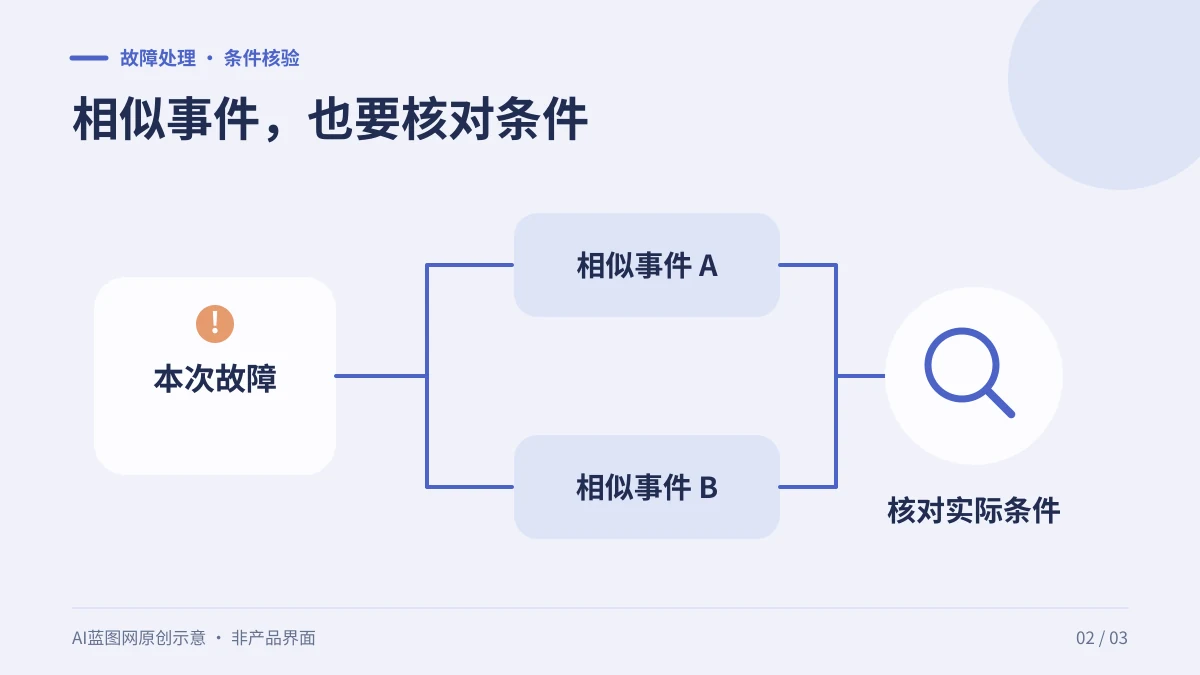
这给落地设计提出一个具体问题:检索返回的旧故障,究竟只是文字相似,还是服务、错误类型和触发条件也相近?相似案例可以提供线索,不能直接作为本次故障原因。
600小时/月,应该怎样读?
按微软披露,该工具已支持40多个团队,产生超过7800次AI辅助交互、近6000次主动事件通知;公司估算每月节省约600个工程工时。交互、通知和工时是三种不同指标,不能换算成“解决了多少故障”,也不代表每个团队都能得到相同收益。
另一个重要边界是,自动采取行动缓解故障仍被列为后续计划,且计划保留工程师确认。现阶段不能把这篇案例写成AI已经独立完成线上修复。
编辑建议:用一次历史故障回放启动试点
下面是一套可自行试验的验收办法,不是微软披露的测试方案:
- 固定一个服务和一段时间。选择已经结案的普通故障,保留当时能看到的告警、日志和文档版本,不把事后根因提前喂给助手。
- 让结果带证据。要求每项建议附相关日志时间、来源链接和待确认条件。没有证据的推测单独列出,避免和事实混在同一段摘要里。
- 同时记录收益与返工。比较人工找齐资料所需时间、AI漏掉的关键信息,以及工程师核对错误建议花的时间。先约定什么叫“找齐”,再讨论是否省时。
- 安排失败样本。加入文档过期、同名报错但根因不同、权限不足等情况,观察助手能否明确停止推断并说明缺口。
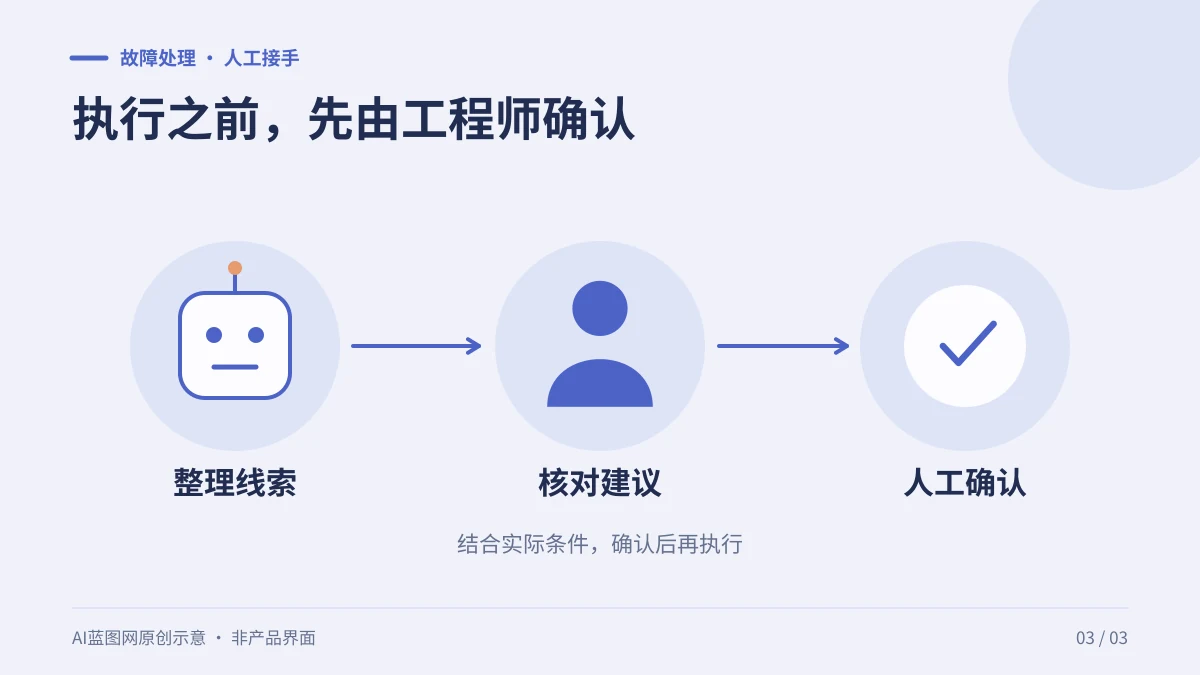
上线初期可把范围限定为读取信息、生成摘要和交接草稿;重启、回滚、改配置等动作另设审批与回退方案。复盘时优先追问“工程师是否更快找到可信依据”,比单看助手发了多少条消息,更接近这个案例真正要解决的问题。
资料核验:2026年10月16日。依据官方资料整理,未进行产品效果实测;配图为Ai蓝图网原创示意,非产品界面。